需要予測モジュールforecastと予測システム ABD-Forecast
予測手法と予測システム ABD-Forecast (AutoML Bayes Deep Forecast)
#hide ## 解釈可能な予測(最適決定木)
解釈可能な人工知能の必要性から,決定木の作成に最適化を適用する.
特徴量が連続の場合の分類は,数理最適化モデルとして記述できる.
#hide ### 最適分類木
Optimal Trees for Prediction and Prescription by Jack William Dunn (MIT PhD Thesis) 2018
変数 - d[t] : ブランチtで分枝をするとき1 - b[t] : ブランチtでの閾値 - a[j,t]: ブランチtが特徴jで分けるとき1 - l[t]: 葉が空でないとき1 - z[i,t]: データiが葉tに入るとき1 - N[k,t] : 葉tに入ったクラスkのデータ数 - c[k,t]: 葉tがクラスkに分類されるとき1 - NN[t]: 葉tに入ったデータの総数 - L[t]: 葉tにおける誤りの数
#hide ### 2値分類のための最適決定木(すべてのデータはカテゴリーデータと仮定)
Optimal Decision Trees for Categorical Data via Integer Programming Oktay Gu ̈nlu ̈k · Jayant Kalagnanam · Minhan Li · Matt Menickelly · Katya Scheinberg
変数
- v[g,t]: グループ g がブランチ t で分割対象となるとき 1
- z[j,t]: 特徴 j がブランチ t で左の子に行くとき 1
- L[i,t]: データ i がブランチ t で左に行くとき 1
- R[i,t]: データ i がブランチ t で右に行くとき 1
- c[i,t]: データ i が葉 t に行くとき 1 SCOP C[i] domain Leaf
定式化
- 各ブランチでは1つのグループが選択される:
for t in Branch:
m.addConstr( quicksum(v[g,t] for g in G) == 1 )- 特徴 j がブランチ t で選ばれるなら,その特徴を含んだグループが選ばれなければならない:
for t in Branch:
    for j in range(p):
m.addConstr( z[j,t] <= v[group[j], t] )- 追加制約 => グループが選ばれるなら,その中の特徴は1つ以上選択
for t in Branch:
    for g in G:
m.addConstr( quicksum(z[j,t] for j in J[g]) >= v[g, t] )- 選択された特徴をもつデータ i は左の子に行き,それ以外は右の子に行く:
for i in range(n):
    for t in Branch:
        m.addConstr( L[i,t] == quicksum( X[i][j]*z[j,t] for j in range(p)) )
m.addConstr( L[i,t] + R[i,t]== 1 )- データ i が葉 t に含まれるなら,その葉に行く先祖点において左(右)に行くデータでなければならない:
for t in Leaf:
    for i in range(n):
        for ansestor in AL[t]:
            m.addConstr( c[i,t] <= L[i,ansestor] )
        for ansestor in AR[t]:
m.addConstr( c[i,t] <= R[i,ansestor] ) - データ i は何れかの葉に含まれなければならない:
for i in range(n):
m.addConstr( quicksum(c[i,t] for t in Leaf) == 1 ) - 目的関数: 正しいクラスの葉に割り当てられたデータの数の合計を最大化:
m.setObjective( quicksum( c[i,t] for i in DataPos for t in LeafPos ) +
                quicksum( c[i,t] for i in DataNeg for t in LeafNeg ), GRB.MAXIMIZE )
需要予測
サプライ・チェインにおける需要の予測のための入力は,一般的には以下の形式をもつデータである.
| 日付時刻 | 顧客 | 製品 | 需要量 | 売上 | 付加情報1 | 付加情報2 | … |
|---|---|---|---|---|---|---|---|
| 2020年1月3日(何時何分) | A商店 | 製品α | 10 | 2600 | 特売日 | … | |
| 2020年1月3日 | B商店 | 製品β | 6 | 6000 | ポイント10倍 | … | |
| … | … | … | … | … | … | … | … |
最初の列は日付時刻型のデータが入る.通常は,日付だけだが,何時何分に購入されたかの情報も入れたい場合には,日付時刻型で入力する. この列をインデックスにすることによって,時間の単位にデータを集約することができる.
2番目と3番目の列には,それぞれ顧客と製品(商品)のデータを入れる. 次の列は,予測をしたいデータ(ターゲット,従属変数)を入れる.通常は,需要量(何個売れたか)を予測するが,それに販売金額を乗じた売上を予測する場合もある. 付加的な情報がある場合には,その次の列に入力する.たとえば,特売日やポイント付加などの情報を入力する. 販売金額が変動する場合には,価格を入れることもある.
予測を行う際には,顧客と製品別に集約し,時系列データに変換してから予測手法を適用する場合が多い. その場合には,(販売金額が一定なら),需要を予測しても,売上を予測しても同じである. 顧客・製品別に予測を行うのは,簡便性のためであるが,顧客ごとの特徴や製品ごとの特徴を考慮できないことがある. さらに,顧客や製品から抽出できる付加情報を,付加情報列に追加しても良い.たとえば,同じ系列の顧客の場合には系列名を追加しておくと,特徴が認識しやすくなる.
日付は,自動的に特徴を表す列に変換して扱うこともある.ここでは,以下の列を追加する.(時刻も考慮する場合には,さらに時間,分,秒の列を追加する.)
- ‘Year’: 年
- ‘Month’: 月
- ‘Day’ : 日
- ‘Dayofweek’: 曜日
- ‘Dayofyear’: 年初からの経過日数
- ‘Is_month_end’: 月の最終日
- ‘Is_month_start’: 月の開始日
- ‘Is_quarter_end’: 四半期の終了日
- ‘Is_quarter_start’: 四半期の開始日
- ‘Is_year_end’: 年の最終日
- ‘Is_year_start’: 何の開始日
- ‘Elapsed’: 経過時間
ここで用いるサンプルデータは, データ生成モジュールのgenerate_demand_with_promo関数を用いて生成したものである. 以下のように読み込んで使用する.
demand_with_promo_df = pd.read_csv(folder + "demand_with_promo.csv", index_col=0)
demand_with_promo_df.head()| date | cust | prod | promo_0 | promo_1 | demand | |
|---|---|---|---|---|---|---|
| 0 | 2019-01-01 | 札幌市 | A | 0 | 0 | 2 |
| 1 | 2019-01-01 | 札幌市 | B | 0 | 0 | 0 |
| 2 | 2019-01-01 | 札幌市 | C | 0 | 0 | 2 |
| 3 | 2019-01-01 | 札幌市 | D | 0 | 0 | 0 |
| 4 | 2019-01-01 | 札幌市 | E | 0 | 0 | 1 |
指数平滑法
サプライ・チェインの古典手法に、指数平滑法と呼ばれる予測法がある。
航空機の乗客数の時系列データを用いて、様々な手法の比較を行う。
Holt-Wintersの季節変動と傾向変動を考慮した指数平滑法
パラメータ
- \(y_t\): 期 \(t\) の実現値
- \(s_t\): 基本水準係数
- \(b_t\): 傾向変動係数
- \(c_t\): 季節変動係数
- \(\hat{y}_{t+m}\): 期 \(t\) における \(m\)期後の予測値
- \(L\) :季節変動の周期 (seasonal_periods)
- \(\alpha\): 平滑化定数 (smoothing_level)
- \(\beta\): 傾向変動に対する平滑化定数 (smoothing_slope)
- \(\gamma\): 季節変動に対する平滑化定数 (smoothing_seasonal)
加法的季節変動: \[ \begin{array}{lll} &s_0 & =& y_0\\ &s_{t} & =& \alpha (y_{t}-c_{t-L}) + (1-\alpha)(s_{t-1} + b_{t-1})\\ &b_{t} &=& \beta (s_t - s_{t-1}) + (1-\beta)b_{t-1}\\ &c_{t} &=& \gamma (y_{t}-s_{t})+(1-\gamma)c_{t-L}\\ &\hat{y}_{t+m} &=& s_t + m b_t+c_{t-L+1+(m-1)\mod L} \end{array} \]
乗法的季節変動:
\[ \begin{array}{lll} s_0 &=& y_0\\ s_{t} &=& \alpha (y_{t}/c_{t-L}) + (1-\alpha)(s_{t-1} + b_{t-1})\\ b_{t} &=& \beta (s_t - s_{t-1}) + (1-\beta)b_{t-1}\\ c_{t} &=& \gamma (y_{t}/s_{t})+(1-\gamma)c_{t-L}\\ \hat{y}_{t+m} &=& (s_t + m b_t) c_{t-L+1+(m-1)\mod L} \end{array} \]
手法
- SimpleExpSmoothing: 単純指数平滑法( \(\gamma\) のみ用いる)
- Holt: Holt法 (\(\beta\) と \(\gamma\) を用いる)
- ExponentialSmoothing: Holt-Wintersの指数平滑法(すべて用いる)
最後の2年間(24ヶ月)をテストデータとする。Holt-Winters法に対しては、パラメータは自動調整とし, Box-Cox変換をしてデータを正規化しておく(引数のuse_boxcoxをTrueにする).
passengers = pd.read_csv("http://logopt.com/data/AirPassengers.csv")
passengers["Month"] = pd.to_datetime(passengers.Month) # Monthの列を日付時刻型に変換
passengers.set_index("Month", inplace=True) #月をインデックスとする
passengers.index.freq ="MS" #月のはじめを頻度にする
passengers.head()

fit1 = SimpleExpSmoothing(passengers[:-24]).fit(smoothing_level=0.2,optimized=False)
fit2 = Holt(passengers[:-24]).fit(smoothing_level=0.8, smoothing_slope=0.2, optimized=False)
fit3 = ExponentialSmoothing(passengers[:-24],seasonal_periods=12, trend='add', seasonal='add').fit()
start, end = len(passengers)-24, len(passengers)
predict1 = fit1.predict(start, end)
predict2 = fit2.predict(start, end)
predict3 = fit3.predict(start, end)
SARIMAX で予測
ARIMA (autoregressive integrated moving average)モデル
\[ y_{t} - y_{t-d} =c + \phi_{1}y_{t-1} + \phi_{2}y_{t-2} + \cdots + \phi_{p}y_{t-p} + \varepsilon_{t} + \theta_{1}\varepsilon_{t-1} + \cdots + \theta_{q}\varepsilon_{t-q} \]
パラメータ
- 自己回帰 AR (autoregressive): \(p\); 過去 \(p\) 期の値の多項式で予測
- 差分 I (integrated): \(d\); \(d\) 期前との差分をとることによって傾向変動を予測
- 移動平均 MA (moving average): \(q\); 過去 \(q\) 期の誤差の多項式で予測
季節変動の追加 SARIMA (seasonal ARIMA)
パラメータ
- 季節自己回帰 SAR: \(P\)
- 季節差分 SI : \(D\)
- 季節移動平均 SMA: \(Q\)
- 周期: \(L\)
SARIMAX 外生変数 (eXogenous variables) の追加
mod = SARIMAX(passengers[:-24],
                                order=(1, 1, 1),
                                seasonal_order=(1, 1, 1, 12),
                                enforce_stationarity=False,
                                enforce_invertibility=False)
fit4 = mod.fit()
predict4 = fit4.predict(start,end)
df = passengers.reset_index()
df.rename(columns={"Month": "ds", "#Passengers": "y"}, inplace=True)model = Prophet(daily_seasonality=False, weekly_seasonality=False, yearly_seasonality=True,seasonality_mode='multiplicative')
model.fit(df[:-24])
future = model.make_future_dataframe(periods=24, freq="MS")
forecast = model.predict(future)
forecast.head()| ds | trend | yhat_lower | yhat_upper | trend_lower | trend_upper | multiplicative_terms | multiplicative_terms_lower | multiplicative_terms_upper | yearly | yearly_lower | yearly_upper | additive_terms | additive_terms_lower | additive_terms_upper | yhat | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 1949-01-01 | 115.732114 | 92.193672 | 116.702905 | 115.732114 | 115.732114 | -0.097351 | -0.097351 | -0.097351 | -0.097351 | -0.097351 | -0.097351 | 0.0 | 0.0 | 0.0 | 104.465421 |
| 1 | 1949-02-01 | 117.417721 | 89.359809 | 112.239922 | 117.417721 | 117.417721 | -0.142170 | -0.142170 | -0.142170 | -0.142170 | -0.142170 | -0.142170 | 0.0 | 0.0 | 0.0 | 100.724450 |
| 2 | 1949-03-01 | 118.940205 | 107.671109 | 130.977234 | 118.940205 | 118.940205 | 0.004902 | 0.004902 | 0.004902 | 0.004902 | 0.004902 | 0.004902 | 0.0 | 0.0 | 0.0 | 119.523276 |
| 3 | 1949-04-01 | 120.625813 | 104.280365 | 128.476356 | 120.625813 | 120.625813 | -0.031312 | -0.031312 | -0.031312 | -0.031312 | -0.031312 | -0.031312 | 0.0 | 0.0 | 0.0 | 116.848788 |
| 4 | 1949-05-01 | 122.257045 | 106.734658 | 130.131457 | 122.257045 | 122.257045 | -0.027676 | -0.027676 | -0.027676 | -0.027676 | -0.027676 | -0.027676 | 0.0 | 0.0 | 0.0 | 118.873491 |
passengers["Exp.Smooth."] = predict1
passengers["Holt"] = predict2
passengers["Holt-Winter"] = predict3
passengers["SARIMAX"] = predict4
passengers["Prophet"] = forecast.loc[:,"yhat"].values
tacked_df = pd.DataFrame(passengers[-24:].stack(),columns=["num"]).reset_index()
fig = px.line(stacked_df,x="Month",y="num",color="level_1")
plotly.offline.plot(fig);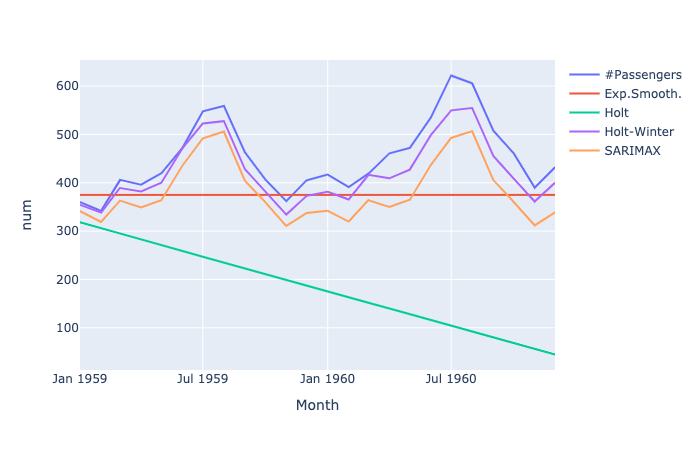
methods = ["Exp.Smooth.", "Holt", "Holt-Winter", "SARIMAX", "Prophet"]
#passengers[-24:]
target = "#Passengers"
metrics_list =[ [] for m in methods]
for i, m in enumerate(methods):
    y_pred = passengers[m][-24:]
    y_true = passengers[target][-24:]

    metrics_list[i] =[ mean_squared_error(y_true, y_pred), mean_absolute_error(y_true, y_pred),
                 mean_squared_log_error(y_true, y_pred), median_absolute_error(y_true, y_pred), max_error(y_true, y_pred) ]

metrics = pd.DataFrame({m:metrics_list[i] for i,m in enumerate(methods)}, index=["mean_squared", "mean_absolute", "mean_squared_log", "median_abusolute", "max"])
metrics| Exp.Smooth. | Holt | Holt-Winter | SARIMAX | Prophet | |
|---|---|---|---|---|---|
| mean_squared | 11560.124288 | 90391.493041 | 1278.707087 | 5719.201415 | 936.384334 |
| mean_absolute | 82.410342 | 270.694737 | 31.076413 | 69.895789 | 25.504026 |
| mean_squared_log | 0.055542 | 1.431378 | 0.005957 | 0.031673 | 0.004042 |
| median_abusolute | 51.102678 | 254.302112 | 29.663906 | 62.913468 | 24.663997 |
| max | 247.102678 | 517.826696 | 74.254745 | 129.229564 | 74.062530 |
Prophet
顧客の需要予測
過去の需要系列dfをもとに、Prophetによる予測を行う関数 forecast_demand を準備する。 比較として、(需要の定常性を仮定して)平均と標準偏差も算出する。
引数:
- demand_df: 需要の系列を表すデータフレーム。顧客Cust、製品Prod,日時Date、需要量demandの列をもつものと仮定する。
- cust_selected: 顧客のリスト
- prod_selected: 製品のリスト
- agg_period: 集約を行う期。例えば1週間を1期とするなら”1w”とする。既定値は1日(“1d”)
- forecast_period: 予測を行う未来の期数。既定値は1
- cumulative: 累積需要量を用いて予測するとき True;既定値はFalse
- lb: 下限値(傾向変動がロジスティック曲線の場合に有効になる.)既定値は0.
- ub: 上限値(傾向変動がロジスティック曲線の場合に有効になる.)既定値は Noneで,その場合にはデータの最大値が設定される.
- kwargs: その他のProphetの引数
Prophetの引数と既定値:
- growth=‘linear’ :傾向変動の関数.規定値は線形.ロジスティック曲線にするには,引数を’logistic’に設定する. また傾向変動をなくすためには引数を ’flat’に設定する.
- changepoints=None : 傾向変更点のリスト
- changepoint_range =0.8 : 傾向変化点の候補の幅(先頭から何割を候補とするか)
- n_changepoints=25 : 傾向変更点の数
- yearly_seasonality=‘auto’ : 年次の季節変動を考慮するか否か
- weekly_seasonality=‘auto’ : 週次の季節変動を考慮するか否か
- daily_seasonality=‘auto’ : 日時の季節変動を考慮するか否か
- holidays=None : 休日のリスト
- seasonality_prior_scale=10.0 : 季節変動の事前分布のスケール値(パラメータの柔軟性をあら表す)
- holidays_prior_scale=10.0 : 休日のの事前分布のスケール値(パラメータの柔軟性をあら表す)
- changepoint_prior_scale=0.05 : 傾向変更点の事前分布のスケール値(パラメータの柔軟性をあら表す)
- mcmc_samples=0 : MCMC法のサンプル数
- interval_width=0.80 : 不確実性の幅
- uncertainty_samples=1000 : 不確実性の幅を計算する際のサンプル数
返値:
以下の情報を列情報にもつデータフレーム
- dic: 顧客と製品のタプルをキーとし、モデルと予測オブジェクトのタプルを値とした辞書
forecast_demand
def forecast_demand(
    demand_df, cust_selected, prod_selected, agg_period:str='1d', forecast_periods:int=1, cumulative:bool=False,
    lb:float=0.0, ub:NoneType=None, kwargs:VAR_KEYWORD
):
Prophetを用いた需要予測(顧客と製品に対して)
forecast_demand関数の使用例
demand_df = pd.read_csv(folder+"demand.csv")

#cust_selected = [ demand_df["cust"].iloc[350] ]
#prod_selected = [ demand_df["prod"].iloc[350] ]
cust_selected = ["前橋市"]
prod_selected = ["F"]

print(cust_selected, prod_selected)
dic = forecast_demand(demand_df, cust_selected, prod_selected, agg_period ="1d", forecast_periods =10, cumulative=False, lb=0., ub=None, growth ="logistic",
                     daily_seasonality=False, weekly_seasonality=True, yearly_seasonality=True)
print(cust_selected[0], prod_selected[0])
if dic[ cust_selected[0], prod_selected[0] ] is not None:
    model, forecast = dic[ cust_selected[0], prod_selected[0] ]
    model.plot(forecast);
else:
    print("too few data")
['前橋市'] ['F']
前橋市 F
too few data特徴量を入れたProphetによる需要予測
過去の需要系列demand_dfとプロモーション情報promo_dfを用いてProphetによる予測を行う関数 forecast_demand_with_featuresを準備する。
引数:
- demand_df: 需要の系列を表すデータフレーム。顧客Cust、製品Prod,日時Date、需要量demandの列をもつものと仮定する。
- cust_selected: 顧客のリスト
- prod_selected: 製品のリスト
- promo_df: プロモーション情報を入れたデータフレーム;demand_dfと同じ日時と、予測する期間に対する日時の情報を含むものとする。
- feature: promo_df内で特徴量として用いる列名のリスト
- agg_period: 集約を行う期。例えば1週間を1期とするなら”1w”とする。既定値は1日(“1d”)
- forecast_period: 予測を行う未来の期数。既定値は1
- cumulative: 累積需要量を用いて予測するとき True;既定値はFalse
- lb: 下限値(傾向変動がロジスティック曲線の場合に有効になる.)既定値は0.
- ub: 上限値(傾向変動がロジスティック曲線の場合に有効になる.)既定値は Noneで,その場合にはデータの最大値が設定される.
- kwargs: その他のProphetのキーワード引数
Prophetの引数と既定値:
- growth=‘linear’ :傾向変動の関数.既定値は線形.ロジスティック曲線にするに’logistic’に設定する.また傾向変動をなくすためには引数を ’flat’に設定する.
- changepoints=None : 傾向変更点のリスト
- changepoint_range =0.8 : 傾向変化点の候補の幅(先頭から何割を候補とするか)
- n_changepoints=25 : 傾向変更点の数
- yearly_seasonality=‘auto’ : 年次の季節変動を考慮するか否か
- weekly_seasonality=‘auto’ : 週次の季節変動を考慮するか否か
- daily_seasonality=‘auto’ : 日時の季節変動を考慮するか否か
- holidays=None : 休日のリスト
- seasonality_prior_scale=10.0 : 季節変動の事前分布のスケール値(パラメータの柔軟性をあら表す)
- holidays_prior_scale=10.0 : 休日のの事前分布のスケール値(パラメータの柔軟性をあら表す)
- changepoint_prior_scale=0.05 : 傾向変更点の事前分布のスケール値(パラメータの柔軟性をあら表す)
- mcmc_samples=0 : MCMC法のサンプル数
- interval_width=0.80 : 不確実性の幅
- uncertainty_samples=1000 : 不確実性の幅を計算する際のサンプル数
返値:
以下の情報を列情報にもつデータフレーム
- dic: 顧客と製品のタプルをキーとし、モデルと予測オブジェクトのタプルを値とした辞書
forecast_demand_with_features
def forecast_demand_with_features(
    demand_df, cust_selected, prod_selected, promo_df:NoneType=None, features:NoneType=None, agg_period:str='1d',
    forecast_periods:int=1, cumulative:bool=False, lb:float=0.0, ub:NoneType=None, kwargs:VAR_KEYWORD
):
Prophetを用いた需要予測(顧客と製品に対して):特徴ベクトルの追加
forecast_demand_with_features関数の使用例
promo_df = pd.read_csv(folder+"promo.csv", index_col=0)
demand_df = pd.read_csv(folder+"demand_with_promo.csv")

cust_selected = [ demand_df["cust"].iloc[90],demand_df["cust"].iloc[101] ]
prod_selected = [ demand_df["prod"].iloc[1] ]
#cust_selected = ["前橋市"]
#prod_selected = ["F"]
print(cust_selected, prod_selected)
dic, df  = forecast_demand_with_features(demand_df, cust_selected, prod_selected, promo_df, features=['promo_0', 'promo_1'],
                                     agg_period ="1d", forecast_periods =0, cumulative=False, growth="linear",
                     daily_seasonality=False, weekly_seasonality=True, yearly_seasonality=True)

if dic[ cust_selected[0], prod_selected[0] ] is not None:
    model, forecast = dic[ cust_selected[0], prod_selected[0] ]
    model.plot(forecast);
else:
    print("too few data")
['札幌市', '仙台市'] ['B']--------------------------------------------------------------------------- AttributeError Traceback (most recent call last) /var/folders/69/5y96sdc94jxf6khgc8mlmxrr0000gn/T/ipykernel_94971/15301494.py in <module> 7 #prod_selected = ["F"] 8 print(cust_selected, prod_selected) ----> 9 dic, df = forecast_demand_with_features(demand_df, cust_selected, prod_selected, promo_df, features=['promo_0', 'promo_1'], 10 agg_period ="1d", forecast_periods =0, cumulative=False, growth="linear", 11 daily_seasonality=False, weekly_seasonality=True, yearly_seasonality=True) /var/folders/69/5y96sdc94jxf6khgc8mlmxrr0000gn/T/ipykernel_94971/3772577099.py in forecast_demand_with_features(demand_df, cust_selected, prod_selected, promo_df, features, agg_period, forecast_periods, cumulative, lb, ub, **kwargs) 45 df["floor"] = lb 46 ---> 47 model = Prophet(**kwargs) 48 49 #プロモーションの特徴ベクトルを追加 ~/Library/Caches/pypoetry/virtualenvs/scmopt-KVX_UVCf-py3.8/lib/python3.8/site-packages/fbprophet/forecaster.py in __init__(self, growth, changepoints, n_changepoints, changepoint_range, yearly_seasonality, weekly_seasonality, daily_seasonality, holidays, seasonality_mode, seasonality_prior_scale, holidays_prior_scale, changepoint_prior_scale, mcmc_samples, interval_width, uncertainty_samples, stan_backend) 139 self.fit_kwargs = {} 140 self.validate_inputs() --> 141 self._load_stan_backend(stan_backend) 142 143 def _load_stan_backend(self, stan_backend): ~/Library/Caches/pypoetry/virtualenvs/scmopt-KVX_UVCf-py3.8/lib/python3.8/site-packages/fbprophet/forecaster.py in _load_stan_backend(self, stan_backend) 152 self.stan_backend = StanBackendEnum.get_backend_class(stan_backend)() 153 --> 154 logger.debug("Loaded stan backend: %s", self.stan_backend.get_type()) 155 156 def validate_inputs(self): AttributeError: 'Prophet' object has no attribute 'stan_backend'
集約したデータに対する予測
demand_df = pd.read_csv(folder+"aggregate_demand.csv")

cust_selected = [ demand_df["cust"].iloc[3] ]
prod_selected = [ demand_df["prod"].iloc[3] ]
print(cust_selected, prod_selected)

dic, df  = forecast_demand_with_features(demand_df, cust_selected, prod_selected, features=[], agg_period ="1d", forecast_periods =100, cumulative=False
                                         ,growth="logistic", daily_seasonality=False, weekly_seasonality=True, yearly_seasonality=True)


print(cust_selected[0], prod_selected[0])
if dic[ cust_selected[0], prod_selected[0] ] is not None:
    model, forecast = dic[ cust_selected[0], prod_selected[0] ]
    model.plot(forecast);
else:
    print("too few data")
['Plnt_Odawara'] ['B']
Plnt_Odawara B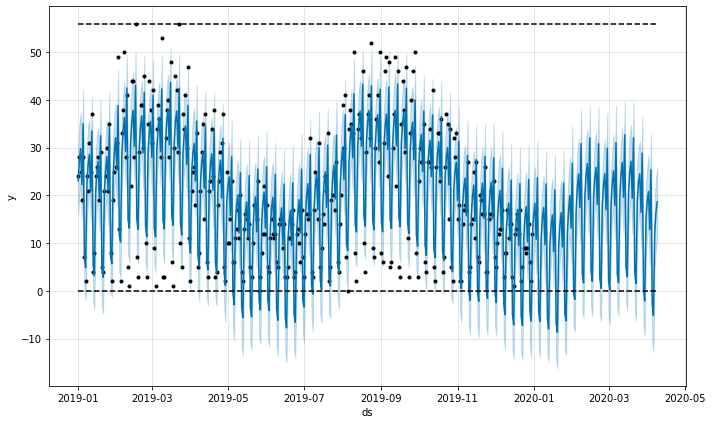
len(forecast)730交差検証
#df_cv = cross_validation(model, initial='220 days', period='100 days', horizon = '100 days')
df_cv = cross_validation(model, initial='200 days', period='30 days', horizon = '60 days')
df_cv.head()
INFO:fbprophet:Making 16 forecasts with cutoffs between 2019-08-08 00:00:00 and 2020-10-31 00:00:00
WARNING:fbprophet:Seasonality has period of 365.25 days which is larger than initial window. Consider increasing initial.| ds | yhat | yhat_lower | yhat_upper | y | cutoff | |
|---|---|---|---|---|---|---|
| 0 | 2019-08-09 | 2.806365 | 1.621363 | 3.974812 | 2 | 2019-08-08 |
| 1 | 2019-08-10 | 4.407486 | 3.145626 | 5.640692 | 5 | 2019-08-08 |
| 2 | 2019-08-11 | 1.621587 | 0.445880 | 2.891954 | 0 | 2019-08-08 |
| 3 | 2019-08-12 | 1.618451 | 0.417103 | 2.789864 | 0 | 2019-08-08 |
| 4 | 2019-08-13 | 3.644485 | 2.507137 | 4.867713 | 3 | 2019-08-08 |
df_p = performance_metrics(df_cv, rolling_window=0.1)
df_p.head()
INFO:fbprophet:Skipping MAPE because y close to 0| horizon | mse | rmse | mae | mdape | coverage | |
|---|---|---|---|---|---|---|
| 0 | 6 days | 1.866793 | 1.366306 | 1.128297 | 0.556571 | 0.625000 |
| 1 | 7 days | 1.823782 | 1.350475 | 1.101126 | 0.452552 | 0.645833 |
| 2 | 8 days | 1.747038 | 1.321756 | 1.099327 | 0.506288 | 0.677083 |
| 3 | 9 days | 1.669610 | 1.292134 | 1.050407 | 0.445765 | 0.697917 |
| 4 | 10 days | 1.858351 | 1.363214 | 1.065813 | 0.410124 | 0.687500 |
plot_cross_validation_metric(df_cv, metric='mse');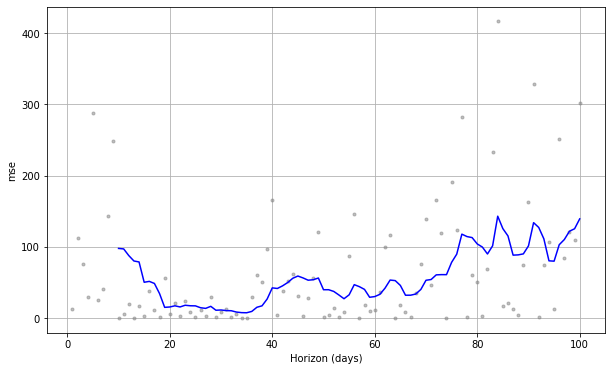
平均や標準偏差も計算
過去の需要系列dfをもとに、Prophetによる予測を行う関数 forecast_prophet を準備する。 比較として、(需要の定常性を仮定して)平均と標準偏差も算出する。
引数:
- demand_df: 需要の系列を表すデータフレーム。顧客Cust、製品Prod,日時Date、需要量demandの列をもつものと仮定する。
- agg_period: 集約を行う期。例えば1週間を1期とするなら”1w”とする。既定値は1日(“1d”)
- forecast_period: 予測を行う未来の期数。既定値は1
返値:
以下の情報を列情報にもつデータフレーム
- mean: 需要の平均
- std : 需要の標準偏差
- Prophet[0..forecast_period-1]: Prophetによる予測から計算された未来のforecast_periods 期分の最大在庫量
forecast_prophet
def forecast_prophet(
    df, agg_period:str='1d', forecast_periods:int=1
):
Prophetを用いた需要予測
forecast_prophet_cust_prod
def forecast_prophet_cust_prod(
    demand_df, cust_selected, prod_selected, agg_period:str='1d', forecast_periods:int=1, cumulative:bool=False
):
Prophetを用いた需要予測(顧客と製品に対して)
# ProphetのWarningがたくさん出る場合には、以下を生かす。
import warnings
warnings.simplefilter('ignore')
demand_df = pd.read_csv(folder+"demand.csv")
cust_selected = [ demand_df["cust"].iloc[0], demand_df["cust"].iloc[-1] ]
prod_selected = [ demand_df["prod"].iloc[0], demand_df["prod"].iloc[-1] ]
print(cust_selected, prod_selected)
forecast_df = forecast_prophet_cust_prod(demand_df, cust_selected, prod_selected, agg_period ="1w", forecast_periods =10)
print(forecast_df.head())forecast_prophet_cust
def forecast_prophet_cust(
    demand_df, cust_selected, agg_period:str='1d', forecast_periods:int=1
):
各顧客に対する(すべての製品の)合計需要の予測
demand_df = pd.read_csv(folder+"demand.csv")
cust_selected = [ demand_df["cust"].iloc[0], demand_df["cust"].iloc[-1] ]
forecast_df = forecast_prophet_cust(demand_df, cust_selected, agg_period ="1w", forecast_periods =10)
print(forecast_df.head())
Prophet Error while computing for 札幌市
Prophet Error while computing for 那覇市
Empty DataFrame
Columns: [cust, mean, std, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Index: []forecast_prophet_prod
def forecast_prophet_prod(
    demand_df, prod_selected, agg_period:str='1d', forecast_periods:int=1
):
各製品に対する(すべての顧客の)合計需要の予測
demand_df = pd.read_csv(folder+"demand.csv")
prod_selected = [ demand_df["prod"].iloc[0], demand_df["prod"].iloc[-1] ]
forecast_df = forecast_prophet_prod(demand_df, prod_selected, agg_period ="1w", forecast_periods =10)
print(forecast_df.head())
Prophet Error while computing for A
Prophet Error while computing for J
Empty DataFrame
Columns: [prod, mean, std, 0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
Index: []深層学習ライブラリ fastai を用いた需要予測
未来の時系列データフレームを生成する関数 make_future_dataframe
過去の時系列データから未来のデータを生成する関数
- history_dates: 過去の時系列データの日付を表す
- finish: 終了日
- periods: 生成する未来の期数
- freq: 生成する期の単位(頻度)を表す文字列; たとえば,1日単位の場合には”1d”とする.
make_future_dataframe
def make_future_dataframe(
    history_dates, periods, freq:str='1d', include_history:bool=True
):
未来の時系列データフレームを生成する関数
make_future_dataframe関数の使用例
#製品/顧客を切り出したデータフレームの保存
promo_df = pd.read_csv(folder+"promo.csv", index_col=0)
demand_df = pd.read_csv(folder+"demand_with_promo.csv",index_col=0)
customer = "仙台市"
product = "A"
agg_period ="1d"
try:
    demand_df.reset_index(inplace=True)
except ValueError:
    pass
demand_df["date"] = pd.to_datetime(demand_df["date"])
demand_df.set_index("date", inplace=True)
demand_grouped = demand_df.groupby(
    ["cust", "prod"]).resample(agg_period)["demand"].sum()

if (customer,product) in demand_grouped:
    df = pd.DataFrame(demand_grouped[customer, product])

# df.reset_index(inplace=True)
# if promo_df is not None:
#     promo_df["date"] = pd.to_datetime(promo_df["date"])
#     df = pd.merge(df, promo_df,on="date", how="left")
#df.to_csv("maebashi-f.csv")
df.head()| demand | |
|---|---|
| date | |
| 2019-01-01 | 13 |
| 2019-01-02 | 19 |
| 2019-01-03 | 17 |
| 2019-01-04 | 12 |
| 2019-01-05 | 19 |
future = make_future_dataframe(history_dates=df.index, periods=10, freq="1w", include_history=False)
future.head()| date | |
|---|---|
| 0 | 2021-01-03 |
| 1 | 2021-01-10 |
| 2 | 2021-01-17 |
| 3 | 2021-01-24 |
| 4 | 2021-01-31 |
Excelのテンプレートを生成する関数 make_excel_forecast
Excelインターフェイスのテンプレートを生成する関数.
引数:
- start: 開始日
- finish: 終了日
- period: 期を構成する単位期間の数;既定値は \(1\)
- period_unit: 期の単位 (時,日,週,月から選択); 既定値は日; periodとあわせて期間の生成に用いる. たとえば,既定値だと1日が1期となる.
- num_features: (休日を除く)特徴の数
- holiday: 日本のカレンダーに基づく休日を表す特徴を追加するときTrue
返値:
- 需要予測用のExcelのWorkbook
make_excel_forecast
def make_excel_forecast(
    start, finish, period:int=1, period_unit:str='日', num_features:int=0, holiday:bool=True
):
Call self as a function.
make_excel_forecast関数の使用例
start = '2015-01-05' #開始日
finish = '2019-1-30'
period=1
period_unit="週"
wb = make_excel_forecast(start, finish, period, period_unit, num_features = 0, holiday=False)
wb.save("forecast-templete.xlsx")
Excelファイルを読み込んで予測を行う関数 forecast_excel
ExcelのWorkbookを与えると予測を記入して返す関数
引数: - wb: 日付,需要,特徴のデータを入れたExcel Workbook - valid_start: 検証開始日 - predict_start: 予測開始日
返値: - wb: 予測結果と誤差の列を追加したExcel Workbook - best: 最良の予測をしたモデルオブジェクト - result_df: 予測結果のデータフレーム - forecast: 最良の予測モデルを用いた予測結果のデータフレーム - demand_df: 予測結果から需要を抽出し,誤差列を追加したデータフレーム - valid_df: demand_dfから検証開始から予測開始の直前までを抜き出したデータフレーム
forecast_excel
def forecast_excel(
    wb, valid_start, predict_start
):
Call self as a function.
forecast_excel関数の使用例
# wb = load_workbook("forecast-ex2.xlsx", data_only=True)
# valid_start = "2019-09-01"
# predict_start = "2020-12-30"

wb = load_workbook("forecast-ex1.xlsx", data_only=True)
valid_start = "2021-02-24"
predict_start = "2021-3-03"

#wb = load_workbook(folder+"forecast-walmart.xlsx", data_only=True)
#valid_start = "2011-8-19"
#predict_start = "2011-12-30"
#wb = load_workbook("forecast-ex5.xlsx", data_only=True)
#valid_start = "2020-10-19"
#predict_start = "2020-12-30"
wb, best, result_df, forecast, demand_df, valid_df = forecast_excel(wb, valid_start, predict_start)| Model | MAE | MSE | RMSE | R2 | RMSLE | MAPE | TT (Sec) | |
|---|---|---|---|---|---|---|---|---|
| dummy | Dummy Regressor | 10.5139 | 228.3212 | 15.1103 | -0.1966 | 0.1213 | 0.0811 | 0.0000 |
[DummyRegressor(constant=None, quantile=None, strategy='mean')]予測に基づく動的発注量シートの生成関数 dynamic_inv_excel
引数: - wb: 在庫シミュレーションシートを入れるExcel Workbook - valid_start: 検証開始日 - predict_start: 予測開始日 - valid_df: demand_dfから検証開始から予測開始の直前までを抜き出したデータフレーム - demand_df: 予測結果から需要を抽出し,誤差列を追加したデータフレーム - h: 在庫費用(定数かリスト); 関数内で需要と同じ長さのNumPy配列に変換される. - fc: 固定費用(定数かリスト); 関数内で需要と同じ長さのNumPy配列に変換される. - vc: 変動費用(定数かリスト); 関数内で需要と同じ長さのNumPy配列に変換される;既定値は0. - z: 安全在庫係数;初期安全在庫量を決めるために使われる定数(既定値は2.33)
返値: - wb: 在庫シミュレーションシートを追加したExcel Workbook
dynamic_inv_excel
def dynamic_inv_excel(
    wb, valid_start, predict_start, valid_df, demand_df, h, fc, vc:float=0.0, z:float=2.33
):
Call self as a function.
dynamic_inv_excel関数の使用例
h = 1
fc = 100.
vc = 0.
z = 1.65
wb = dynamic_inv_excel(wb, valid_start, predict_start, valid_df, demand_df, h, fc, vc, z)
wb.save("forecast-ex5-simu.xlsx")
2995.525076709324 [44.36038177 0. 0. 65.51441261 0. 0.
0. 0. 61.73584662 0. 0. 49.47059588
0. 0. 0. 0. 57.16618104 0.
0. 0. 0. 0. 50.6413246 0.
0. 0. 29.14120463 0. 0. 0.
54.8727735 0. 0. 0. 0. 0.
60.59831692 0. 0. 0. 0. 0.
0. 51.70768912 0. 0. 0. 0.
0. 0. 53.16539093 0. 0. 0.
0. 0. 0. 48.67772177 0. 0.
0. 0. 0. 0. 52.11188276 0.
0. 0. 0. 0. 0. 0.
62.27572896 0. 0. 0. 0. 0.
53.92021115 0. 0. 42.08768594 0. 0. ]顧客と製品を与えると、訓練用データフレームと予測用の未来のデータフレームを生成する関数
需要がない日を自動的に追加し,その需要を0と補完する.
引数: - demand_df: 需要データフレーム - customer: 予測を行いたい顧客 - product: 予測を行うたい製品 - promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある. - agg_period: 期間を表す文字列(例えば1日のときは”1d”) - forecast_periods: 予測したい期間
返値: - df: 訓練用データフレーム - future: 訓練用と予測用の未来のデータを入れたデータフレーム
make_forecast_df
def make_forecast_df(
    demand_df, customer, product, promo_df:NoneType=None, agg_period:str='1d', forecast_periods:int=1
):
顧客と製品を与えると、訓練用データフレームと予測用の未来のデータフレームを生成する関数
make_forecast_df関数の使用例
c = "仙台市"
p = "A"
agg_period ="1d"
df, future = make_forecast_df(demand_df, customer=c, product=p,promo_df= promo_df, agg_period=agg_period, forecast_periods = 10)
df.head()| demand | promo_0 | promo_1 | Year | Month | Week | Day | Dayofweek | Dayofyear | Is_month_end | Is_month_start | Is_quarter_end | Is_quarter_start | Is_year_end | Is_year_start | Elapsed | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 13 | 0 | 0 | 2019 | 1 | 1 | 1 | 1 | 1 | False | True | False | True | False | True | 1.546301e+09 |
| 1 | 19 | 1 | 0 | 2019 | 1 | 1 | 2 | 2 | 2 | False | False | False | False | False | False | 1.546387e+09 |
| 2 | 17 | 0 | 0 | 2019 | 1 | 1 | 3 | 3 | 3 | False | False | False | False | False | False | 1.546474e+09 |
| 3 | 12 | 0 | 0 | 2019 | 1 | 1 | 4 | 4 | 4 | False | False | False | False | False | False | 1.546560e+09 |
| 4 | 19 | 0 | 0 | 2019 | 1 | 1 | 5 | 5 | 5 | False | False | False | False | False | False | 1.546646e+09 |
実データでの分析
全てのデータを用いて深層学習による予測をするためのデータフレームの生成関数
データ数が不足している場合には、顧客や製品もカテゴリー変数として扱うことによって十分なデータを確保することができる。
引数: - demand_df: 需要データフレーム - promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある. - agg_period: 期間を表す文字列(例えば1日のときは”1d”)
返値: - demand_df: 訓練用データフレーム
make_forecast_df_all
def make_forecast_df_all(
    demand_df, promo_df:NoneType=None, agg_period:str='1d', forecast_periods:int=1
):
全データに対する訓練用データフレームを生成する関数
demand_df = pd.read_csv(folder+"demand_with_promo.csv", index_col=0)
all_df, future = make_forecast_df_all(demand_df, promo_df, agg_period="1d")
all_df.head()| cust | prod | Week | promo_0 | promo_1 | demand | Year | Month | Day | Dayofweek | Dayofyear | Is_month_end | Is_month_start | Is_quarter_end | Is_quarter_start | Is_year_end | Is_year_start | Elapsed | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 仙台市 | A | 1 | 0 | 0 | 13 | 2019 | 1 | 1 | 1 | 1 | False | True | False | True | False | True | 1546300800 |
| 1 | 仙台市 | A | 1 | 1 | 0 | 19 | 2019 | 1 | 2 | 2 | 2 | False | False | False | False | False | False | 1546387200 |
| 2 | 仙台市 | A | 1 | 0 | 0 | 17 | 2019 | 1 | 3 | 3 | 3 | False | False | False | False | False | False | 1546473600 |
| 3 | 仙台市 | A | 1 | 0 | 0 | 12 | 2019 | 1 | 4 | 4 | 4 | False | False | False | False | False | False | 1546560000 |
| 4 | 仙台市 | A | 1 | 0 | 0 | 19 | 2019 | 1 | 5 | 5 | 5 | False | False | False | False | False | False | 1546646400 |
検証期間を設定するための関数 find_horizon
find_horizon
def find_horizon(
    demand_df, ratio:float=0.9
):
Call self as a function.
demand_df = pd.read_csv(folder+"demand_with_promo.csv")
find_horizon(demand_df, ratio=0.9)
Timestamp('2020-10-19 00:00:00')訓練データと検証データのインデックスを準備する関数 prepare_index
引数:
- df: 日付情報(Year列、Month列、Day列)を含んだデータフレーム
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる。Noneのときには最後の100日を検証データとする。
返値: - train_idx: 訓練データのインデックス - valid_idx: 検証データのインデックス
prepare_index
def prepare_index(
    df, horizon:NoneType=None
):
Call self as a function.
#train_idx, valid_idx =prepare_index(df, horizon="2020/11/21")
#len(train_idx), len(valid_idx)
訓練
需要を連続量とする場合と離散量とする場合で異なる予測を行う。連続量の場合には回帰問題となり、離散量の場合には分類問題になる。
学習器を作成する関数 make_learn
引数:
- df: 日付 (date)と需要 (deman)の列を含んだデータフレーム
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる。
- classification: 分類問題としてモデルを作成する場合にはTrue、回帰問題としてモデルを作成する場合には Falseを入れる。
返値:
- learn: fastaiの学習器
make_learn
def make_learn(
    df, horizon:NoneType=None, classification:bool=False
):
深層学習を用いた需要予測用のデータを生成
make_learn関数の使用例
learn = make_learn(df, horizon="2020-10-01", classification=False)
#learn = make_learn(all_df, horizon="2016-10-01", classification=False)
#learn = make_learn(all_df, horizon="2020-10-01", classification=False)
#df.drop("level_0", axis=1, inplace=True)
#learn = make_learn(df, horizon="2016-12-01", classification=False)
INFO:numexpr.utils:Note: NumExpr detected 16 cores but "NUMEXPR_MAX_THREADS" not set, so enforcing safe limit of 8.
INFO:numexpr.utils:NumExpr defaulting to 8 threads.適正な学習率を見つけるための関数 lr_find
lr_min= learn.lr_find()
print(lr_min)SuggestedLRs(valley=0.002511886414140463)lr_findの結果をPlotlyで描画する関数 plot_lr_find
plot_lr_find
def plot_lr_find(
    learn
):
Call self as a function.
fig = plot_lr_find(learn)
plotly.offline.plot(fig);
訓練を行う関数 train
引数: - learn: 学習器 - kwargs: 訓練を行う関数fit_one_cycleの任意のキーワード引数
https://docs.fast.ai/callback.schedule#Learner.fit_one_cycle 参照
train
def train(
    learn, kwargs:VAR_KEYWORD
):
fit_one_cycle法を用いて訓練を行う関数
train(learn, n_epoch = 30, lr_max =0.01, wd=2., cbs=ShowGraphCallback())| epoch | train_loss | valid_loss | _rmse | mae | msle | time |
|---|---|---|---|---|---|---|
| 0 | 3446.414062 | 7105.580566 | 84.294609 | 66.609749 | 4.805219 | 00:03 |
| 1 | 2210.760254 | 1613.519287 | 40.168633 | 26.273926 | 2.868655 | 00:03 |
| 2 | 1863.013672 | 656.649414 | 25.625174 | 13.304914 | 0.741323 | 00:03 |
| 3 | 1639.386475 | 976.197571 | 31.244160 | 14.256841 | 0.766732 | 00:03 |
| 4 | 1687.551270 | 648.089172 | 25.457594 | 12.055953 | 0.347193 | 00:03 |
| 5 | 1956.444458 | 1265.262207 | 35.570530 | 14.617914 | 0.479162 | 00:03 |
| 6 | 1698.531738 | 466.392212 | 21.596113 | 11.547545 | 1.536979 | 00:03 |
| 7 | 2314.256104 | 1495.722778 | 38.674576 | 16.015421 | 0.508270 | 00:03 |
| 8 | 1567.057861 | 456.358246 | 21.362545 | 17.110693 | 1.679504 | 00:03 |
| 9 | 1580.399536 | 583.629700 | 24.158430 | 16.468655 | 1.654195 | 00:03 |
| 10 | 1677.902344 | 658.983154 | 25.670668 | 14.227415 | 0.733416 | 00:03 |
| 11 | 1710.951782 | 3192.795898 | 56.504829 | 31.815025 | 1.787573 | 00:03 |
| 12 | 1314.445557 | 1115.158813 | 33.393997 | 17.580637 | 2.050577 | 00:03 |
| 13 | 1093.038452 | 407.138885 | 20.177683 | 11.029508 | 0.769333 | 00:03 |
| 14 | 954.789368 | 1112.169678 | 33.349209 | 16.030300 | 1.018057 | 00:03 |
| 15 | 1350.003052 | 617.209290 | 24.843697 | 12.732859 | 0.934637 | 00:03 |
| 16 | 1671.424316 | 484.320282 | 22.007277 | 11.749466 | 0.757320 | 00:03 |
| 17 | 800.749023 | 998.935669 | 31.605944 | 15.915786 | 0.790849 | 00:03 |
| 18 | 749.288147 | 683.855164 | 26.150621 | 13.572218 | 1.163126 | 00:03 |
| 19 | 858.682617 | 876.759644 | 29.610126 | 13.271565 | 0.624707 | 00:03 |
| 20 | 594.039185 | 418.807831 | 20.464794 | 8.975345 | 0.675335 | 00:03 |
| 21 | 476.235504 | 276.303314 | 16.622375 | 9.983256 | 0.377772 | 00:03 |
| 22 | 443.672668 | 179.968506 | 13.415236 | 6.672860 | 0.587208 | 00:03 |
| 23 | 423.546722 | 132.249161 | 11.499963 | 5.285238 | 0.299202 | 00:03 |
| 24 | 334.764893 | 209.028351 | 14.457813 | 6.568413 | 0.476533 | 00:03 |
| 25 | 208.162155 | 72.868652 | 8.536314 | 4.375165 | 0.419365 | 00:03 |
| 26 | 155.964676 | 41.782406 | 6.463932 | 3.183359 | 0.320197 | 00:04 |
| 27 | 119.822289 | 44.234440 | 6.650898 | 3.861167 | 0.297581 | 00:03 |
| 28 | 93.038322 | 25.414803 | 5.041310 | 2.986454 | 0.235738 | 00:03 |
| 29 | 86.351746 | 15.100967 | 3.885997 | 2.207297 | 0.232204 | 00:03 |
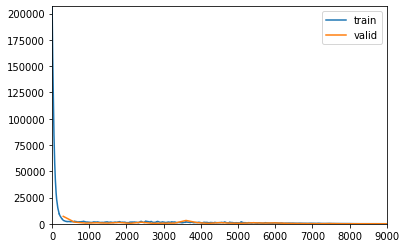
Plotlyで損出関数を描画する関数 plot_loss
引数: - learn: 学習器 - valid: テストデータも描画するときにTrue(既定値)
返り値: - fig: 損出関数のグラフ
plot_loss
def plot_loss(
    learn, valid:bool=True
):
Call self as a function.
fig = plot_loss(learn)
plotly.offline.plot(fig);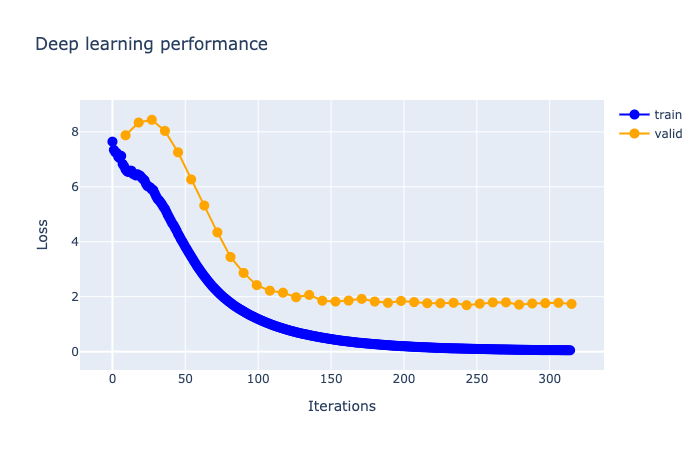
深層学習を用いて予測を行う関数 predict_using_dl
引数: - learn:学習器 - df: 日付 (date)と需要 (deman)の列を含んだデータフレーム - future: 訓練用と予測用の未来のデータを入れたデータフレーム - classification: 分類問題のとき True、それ以外のとき False
返値: - fig: 予測結果を入れた図オブジェクト - predict: 予測結果を入れた配列 - error: 予測の2乗誤差 - r2: 決定係数
predict_using_dl
def predict_using_dl(
    learn, df, future, classification:bool=False
):
深層学習を用いた予測
predict_using_dl関数の使用例
fig, yhat, error, r2 = predict_using_dl(learn, df, future, classification=False)
print("error=", error, r2)
plotly.offline.plot(fig);
error= 103425.1953125 0.023292243480682373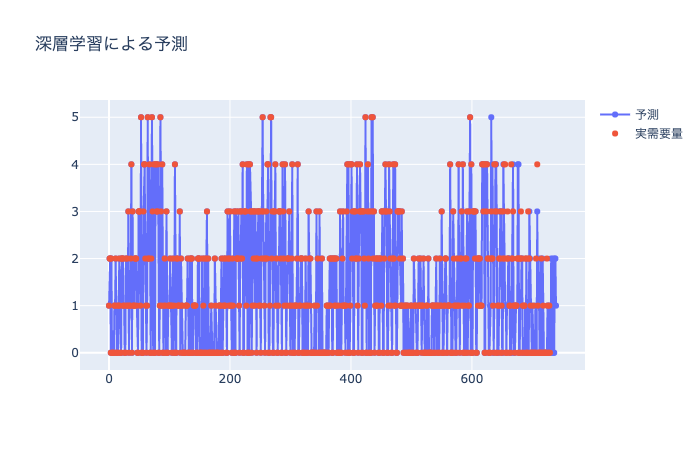
全てのデータで訓練した学習器による予測関数 predict_using_all_dl
引数:
- learn: 学習器
- df: 該当する顧客と製品の需要データを入れたデータフレーム
- furure: 予測したい全期間の需要以外のデータを入れたデータフレーム
- customer: 顧客名
- product: 製品名
- classification: 分類問題のとき True、それ以外のとき False
返値:
- fig: 予測結果を入れた図オブジェクト
- predict: 予測結果を入れた配列
- error: 予測の2乗誤差
predict_using_all_dl
def predict_using_all_dl(
    learn, df, future, customer, product, classification:bool=True
):
深層学習を用いた予測(全部で訓練)
predict_using_all_dl関数の使用例
# demand_df = pd.read_csv(folder+"demand_with_promo.csv", index_col=0)
c = "前橋市"
p = "B"
df, future = make_forecast_df(demand_df, customer=c, product=p, promo_df= promo_df, agg_period="1d", forecast_periods =100)
fig, predict, error, r2 = predict_using_all_dl(learn, df, future, customer=c, product = p, classification=False)
print("error=", error, r2)
plotly.offline.plot(fig);
error= 15.100969314575195 0.9979501962661743#hide_iinput
Image("../figure/predict_using_all_dl.png")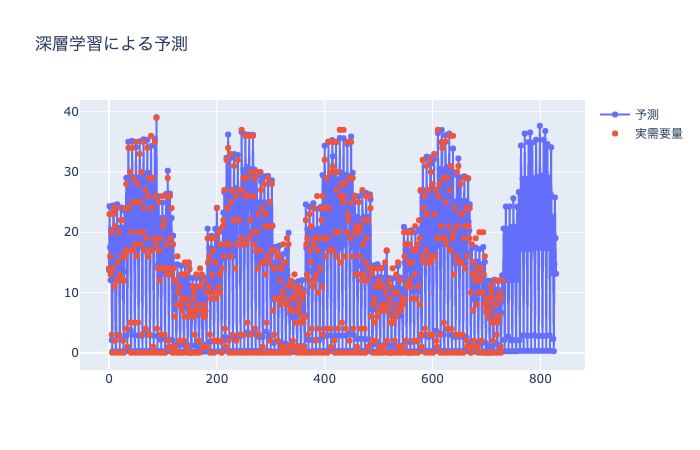
埋め込み層の描画関数 draw_embedding
引数:
- learn: 学習器(訓練済み)
- cust: 顧客を描画するときTrue, 製品を描画するとき False
- pca: 主成分分析で次元削減するときTrue、TSNEでするとき False
返値:
- fig: Plotlyの図オブジェクト
draw_embedding
def draw_embedding(
    learn, cust:bool=True, pca:bool=True
):
draw embedding
draw_embedding関数の使用例
fig = draw_embedding(learn, cust=False, pca=True)
plotly.offline.plot(fig);
fig = draw_embedding(learn, cust=True, pca=True)
plotly.offline.plot(fig);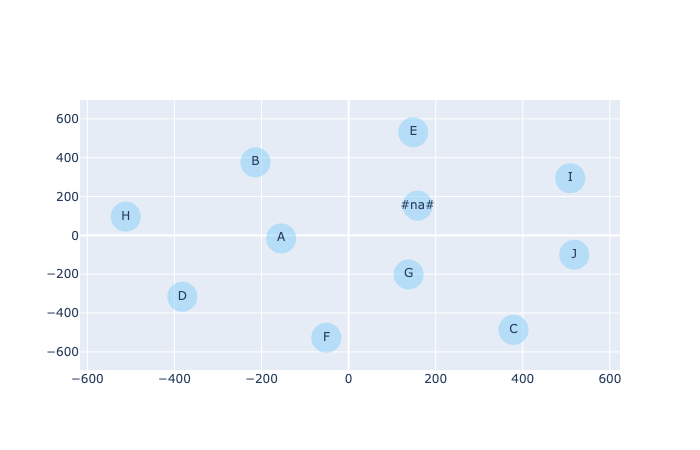
scikit learnのランダム森によって予測をする関数 random_forest
引数:
- df: 日付 (date)と需要 (deman)の列を含んだデータフレーム
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる。
- feature: 特徴ベクトルとして使用する列名のリスト; Noneのときには全ての列とする。
- classification: 分類問題のときTrue、回帰問題のときFalse
返値:
- forest: ランダム森のモデルオブジェクト
- importance: permutation_importanceによる特徴ベクトルの重要度の情報
random_forest
def random_forest(
    df, horizon:NoneType=None, feature:NoneType=None, classification:bool=False
):
ランダム森による需要予測
random_forest関数の呼び出し例
# list(imp[imp.importance>0.01].features)
#feature = ['promo_1', 'Week', 'Month', 'Dayofyear', 'promo_0', 'Dayofweek']
#feature = list(df.columns[1:])
feature = None
forest, importance = random_forest(df, horizon="2020-10-01", feature=feature, classification=False)
重要度のデータフレームと図を返す関数 show_importance
引数: - importance: 重要度(順列重要度を random_forest関数で計算したときの返値として得られる.) - feature: 特徴ベクトルの名前のリスト - df: データフレーム;特徴ベクトルの元の列名を得るためだけに使用する.
返値: imp_df: 重要度を入れたデータフレーム fig: 重要度の棒グラフ
show_importance
def show_importance(
    importance, feature, df
):
Call self as a function.
feature = None
imp_df, fig = show_importance(importance, feature=feature, df=df)
plotly.offline.plot(fig);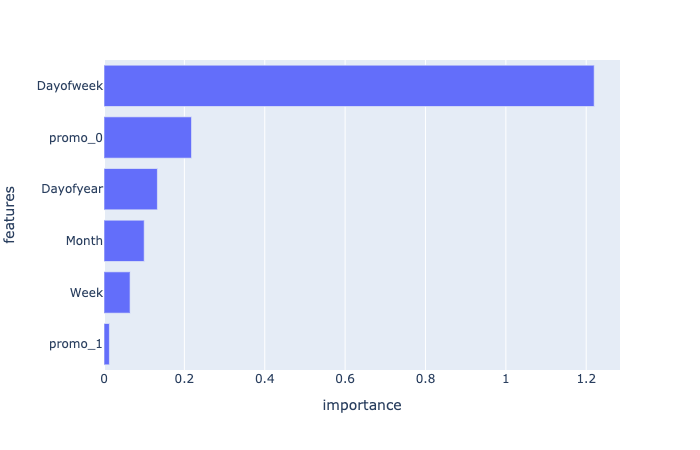
ランダム森による予測 predict_using_rf
引数: - df: 日付 (date)と需要 (deman)の列を含んだデータフレーム - future: 訓練用と予測用の未来のデータを入れたデータフレーム - forest: ランダム森のモデルオブジェクト - horizon: 予測期間
返値: - fig: 予測結果を入れた図オブジェクト - predict: 予測結果を入れた配列 - error: 予測の2乗誤差 - r2: 決定係数
predict_using_rf
def predict_using_rf(
    df, future, forest, horizon:NoneType=None, feature:NoneType=None
):
ランダム木を用いた予測
fig, yhat_rf, error_rf, r2 =  predict_using_rf(df, future, forest, horizon="2020-10-01", feature=feature)
plotly.offline.plot(fig);
print("error", error_rf, r2)
error 1.0633877777777778 0.5972015993265993error 1.1132505494505496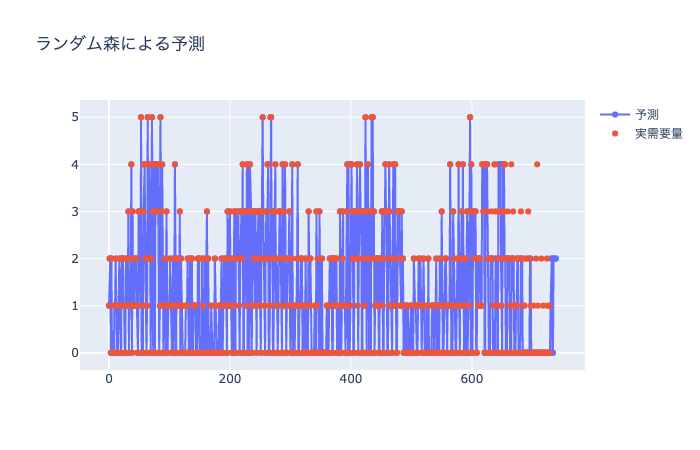
AutoMLで予測をする関数 automl
AutoMLパッケージPyCaretによる予測
引数:
- df: 日付 (date)と需要 (demand)の列を含んだデータフレーム
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる。Noneの場合には100日前からが検証データになる.
- num_bests: 最良モデルの選択数
- sort: 良い順に並べるときの評価尺度名(既定値は”R2”)
- model_name:
返値:
- best: 最良の予測をしたモデルオブジェクト
- result_df: 結果のデータフレーム
automl
def automl(
    df, horizon:NoneType=None, num_bests:int=5, sort:str='R2', model_name:NoneType=None
):
Prediction using pycaret regression models
automl関数の使用例
horizon="2020/10/01"
best, result_df = automl(df, horizon, 5, model_name=None)| Model | MAE | MSE | RMSE | R2 | RMSLE | MAPE | TT (Sec) | |
|---|---|---|---|---|---|---|---|---|
| et | Extra Trees Regressor | 1.6620 | 4.9674 | 2.2288 | 0.9262 | 0.3713 | 0.2443 | 0.1500 |
| rf | Random Forest Regressor | 2.3624 | 7.3216 | 2.7058 | 0.8913 | 0.4690 | 0.3809 | 0.1900 |
| dt | Decision Tree Regressor | 2.4286 | 10.6044 | 3.2564 | 0.8425 | 0.5424 | 0.3973 | 0.0100 |
| gbr | Gradient Boosting Regressor | 3.3336 | 14.5483 | 3.8142 | 0.7840 | 0.4328 | 0.5026 | 0.0800 |
| ada | AdaBoost Regressor | 5.7564 | 40.3512 | 6.3523 | 0.4008 | 0.8888 | 1.1191 | 0.1200 |
| br | Bayesian Ridge | 6.5873 | 61.8033 | 7.8615 | 0.0823 | 1.0977 | 1.7060 | 0.0100 |
| ridge | Ridge Regression | 6.6831 | 63.5019 | 7.9688 | 0.0571 | 1.1030 | 1.7497 | 0.0100 |
| huber | Huber Regressor | 6.4650 | 63.8005 | 7.9875 | 0.0527 | 1.0793 | 1.4744 | 0.0200 |
| kr | Kernel Ridge | 6.5818 | 65.3509 | 8.0840 | 0.0296 | 1.0998 | 1.5512 | 0.1100 |
| en | Elastic Net | 6.7439 | 67.1895 | 8.1969 | 0.0023 | 1.1457 | 1.7762 | 0.0100 |
| lasso | Lasso Regression | 6.7995 | 68.3639 | 8.2682 | -0.0151 | 1.1519 | 1.7897 | 0.0100 |
| tr | TheilSen Regressor | 7.0673 | 69.5302 | 8.3385 | -0.0324 | 1.1465 | 1.8813 | 1.6900 |
| lr | Linear Regression | 7.0492 | 69.5646 | 8.3405 | -0.0329 | 1.1389 | 1.8974 | 0.0000 |
| lar | Least Angle Regression | 7.0492 | 69.5646 | 8.3405 | -0.0329 | 1.1389 | 1.8974 | 0.0100 |
| ard | Automatic Relevance Determination | 7.0675 | 69.8744 | 8.3591 | -0.0375 | 1.1409 | 1.8141 | 0.0100 |
| omp | Orthogonal Matching Pursuit | 7.1926 | 71.5753 | 8.4602 | -0.0628 | 1.1591 | 1.8336 | 0.0000 |
| svm | Support Vector Regression | 7.0575 | 72.9081 | 8.5386 | -0.0826 | 1.1784 | 1.8887 | 0.0200 |
| llar | Lasso Least Angle Regression | 7.2027 | 75.3612 | 8.6811 | -0.1190 | 1.1951 | 1.9659 | 0.0000 |
| dummy | Dummy Regressor | 7.2027 | 75.3612 | 8.6811 | -0.1190 | 1.1951 | 1.9659 | 0.0000 |
| ransac | Random Sample Consensus | 8.5524 | 105.8737 | 10.2895 | -0.5721 | 1.2047 | 2.2048 | 0.0500 |
| knn | K Neighbors Regressor | 9.4000 | 117.2127 | 10.8265 | -0.7404 | 1.3451 | 2.7281 | 0.0000 |
| par | Passive Aggressive Regressor | 8.5968 | 122.1332 | 11.0514 | -0.8135 | 1.2091 | 0.8227 | 0.0000 |
| mlp | MLP Regressor | 7927.3291 | 62842730.7068 | 7927.3407 | -933111.6422 | 6.9995 | 1633.9990 | 0.2000 |
#予測
result = predict_model(best[0], df)
result.head()| demand | promo_0 | promo_1 | Year | Month | Week | Day | Dayofweek | Dayofyear | Is_month_end | Is_month_start | Is_quarter_end | Is_quarter_start | Is_year_end | Is_year_start | Elapsed | Label | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 13 | 0 | 0 | 2019 | 1 | 1 | 1 | 1 | 1 | False | True | False | True | False | True | 1.546301e+09 | 13.0 |
| 1 | 19 | 1 | 0 | 2019 | 1 | 1 | 2 | 2 | 2 | False | False | False | False | False | False | 1.546387e+09 | 19.0 |
| 2 | 17 | 0 | 0 | 2019 | 1 | 1 | 3 | 3 | 3 | False | False | False | False | False | False | 1.546474e+09 | 17.0 |
| 3 | 12 | 0 | 0 | 2019 | 1 | 1 | 4 | 4 | 4 | False | False | False | False | False | False | 1.546560e+09 | 12.0 |
| 4 | 19 | 0 | 0 | 2019 | 1 | 1 | 5 | 5 | 5 | False | False | False | False | False | False | 1.546646e+09 | 19.0 |
#plot_model(best[1], display_format="streamlit")複数の製品・顧客に対して予測を行う関数(のサブ関数) automl_all_sub
サプライ・チェイン最適化のためには,すべての顧客と製品に対して一度に需要予測を行う必要がある.しかし,通常は顧客数,製品数ともに非常に多い場合には,計算時間が問題になる.顧客や製品に対するABC分析を事前に行い,A製品(A顧客)に対してだけ,需要予測を行うという経験的手法が従来使われていたが,ここではデータに基づいた手法を考える.
需要予測は,顧客・製品ごとに時系列データ(にプロモーション情報を付加したもの)を抽出し,AutoMLで複数の機械学習・統計分析モデルを適用して,最も良いものを使うことにする.評価尺度としては決定係数を使う.決定係数が負のものは平均を用いた単純な予測より当たらないことを意味する.
顧客・製品ごとに需要の合計量を被増加順に並べ,大きいものから順に予測を行っていく.一般に,zip分布にしたがう需要を想定すると,需要の合計が小さい場合には,どのような予測をしても当たらなくなる.複数の手法を試し,最も良い予測の決定係数が負のものが続く場合には,需要が小さすぎてこれ以上予測をしても無駄だと判断できる.したがって,決定係数が負のものが適当な数(たとえば10)より大きくなったら,予測をやめて,顧客・製品ごとの需要の平均値と標準偏差だけで管理するものとする.
引数:
- demand_df: 顧客 (cust)・製品 (prod) ごとの日付 (date)と需要 (deman)の列を含んだデータフレーム
- promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある.
- cust_list: 予測を行いたい顧客のリスト
- prod_list 予測を行うたい製品のリスト
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる.
- agg_period: 期間を表す文字列(例えば1日のときは”1d”)
- forecast_periods: 予測したい期間(既定値は1)
- threshold: 需要の予測誤差の幅を決めるためのパラメータ;外れる確率がthresholdになるように下限と上限を決める.
- max_neg_r2: 予測打ち切りのためのパラメータ;この回数だけ R2 が負になったら,それ以上予測する必要はないので, 終了する. ただし,cust_list と prod_listは需要量の降順になっているものと仮定する.
返値: - summary: 予測結果をまとめたデータフレーム;以下の列をもつ.
- cust: 顧客名
- prod: 製品名
- model: 最も良い予測モデル名
- rmse: 平均2乗誤差の平方根
- r2: 決定係数
- forecast: 未来の予測値
- lb: 予測誤差がlb以下になる確率がthresholdになるように設定
- ub: 予測誤差がub以上になる確率がthresholdになるように設定
automl_all_sub
def automl_all_sub(
    demand_df, promo_df, cust_list, prod_list, horizon, agg_period:str='1d', forecast_periods:int=1,
    threshold:float=0.05, max_neg_r2:int=10
):
Call self as a function.
複数の製品・顧客に対して予測を行う関数 automl_all
model 列には,最も良い(決定係数が1に近い)モデル名が保管されている.これを用いて,未来の予測をしたい場合には,そのモデルだけで予測をすれば良い.
予測値と実際の需要量が大きく外れた場合には,原因を探ったり,再予測を行ったりする必要がある.それには,予測誤差の下限と上限(lb,ub列)を用いれば良い.実際の運用ができるような,自動処理を行うシステムは,MLOpsと呼ばれる.
ここで開発したものは,MLOpsの基礎として使うことができる.
引数:
- demand_df: 顧客 (cust)・製品 (prod) ごとの日付 (date)と需要 (deman)の列を含んだデータフレーム
- promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある.
- horizon: 検証データを作成するときの閾値の日付;この日付より後のデータは検証データになる.
- agg_period: 期間を表す文字列(例えば1日のときは”1d”)
- forecast_periods: 予測したい期間(既定値は1)
- threshold: 需要の予測誤差の幅を決めるためのパラメータ;外れる確率がthresholdになるように下限と上限を決める.
- max_neg_r2: 予測打ち切りのためのパラメータ;この回数だけ \(R^2\) が負になったら,それ以上予測する必要はないので, 終了する. ただし,cust_list と prod_listは需要量の降順になっているものと仮定する.
- abc_threshold: ABC分析のための閾値のリスト(合計が1.0になっている必要がある.)
返値: - summary: 予測結果をまとめたデータフレーム;以下の列をもつ.(ただし予測を打ち切った行以降は model以降の列はNaNになる.)
- cust: 顧客名
- prod: 製品名
- mean: 平均需要量
- std: 需要の標準偏差
- rank: 需要の降順ランク
- abc: 需要量のABC分析の結果
- model: 最も良い予測モデル名
- rmse: 平均2乗誤差の平方根
- r2: 決定係数
- forecast: 未来の予測値
- lb: 予測誤差がlb以下になる確率がthresholdになるように設定
- ub: 予測誤差がub以上になる確率がthresholdになるように設定
automl_all
def automl_all(
    demand_df, promo_df, horizon, agg_period:str='1d', forecast_periods:int=1, threshold:float=0.05,
    max_neg_r2:int=10, abc_threshold:list=[0.6, 0.2, 0.2]
):
Call self as a function.
automl_all関数の使用例
#summary = automl_all(demand_df, promo_df, horizon="2020/10/19", agg_period="1d", forecast_periods =10, threshold= 0.05, max_neg_r2 = 1)summary.r2.hist();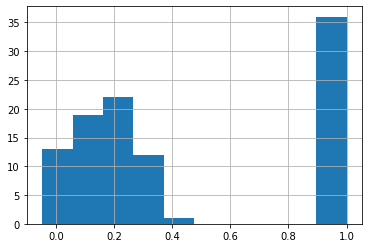
summary.to_csv("summary.csv")
#summary = pd.read_csv("summary.csv", index_col=0)
#summary.sort_values(by="r2",inplace=True)
summary.r2.hist();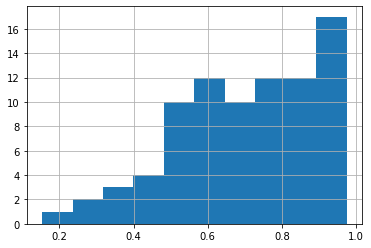
すべての顧客・需要の予測結果を用いて,予測を行い図を返す関数 predict_using_automl_all_fig
引数:
- demand_df: 顧客 (cust)・製品 (prod) ごとの日付 (date)と需要 (deman)の列を含んだデータフレーム
- promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある.
- summary: 予測結果をまとめたデータフレーム(automl_allの返値)
- customer: 顧客名
- product: 製品名
- agg_period: 期間を表す文字列(例えば1日のときは”1d”)
- forecast_periods: 予測したい期間(既定値は1)
返値: - forecast: 未来の予測値(リスト)
predict_using_automl_all_fig
def predict_using_automl_all_fig(
    demand_df, promo_df, summary, customer, product, agg_period:str='1d', forecast_periods:int=10
):
Call self as a function.
agg_df,category = abc.abc_analysis_all(demand_df,[0.6, 0.2, 0.2])
agg_df.reset_index(inplace=True)
count = 0
for row in agg_df.itertuples():
    fig, error, result = predict_using_automl_all_fig(demand_df, None, summary, row.cust, row.prod, agg_period='1d', forecast_periods=10)
    plotly.offline.plot(fig)
    count +=1
    if count>=10:
break| MAE | MSE | RMSE | R2 | RMSLE | MAPE | |
|---|---|---|---|---|---|---|
| 0 | 245.907394 | 123375.59375 | 351.248596 | 0.1176 | 2.8776 | 2.9054 |
| Model | MAE | MSE | RMSE | R2 | RMSLE | MAPE | |
|---|---|---|---|---|---|---|---|
| 0 | Ridge Regression | 245.9074 | 123375.5938 | 351.2486 | 0.1176 | 2.8776 | 2.9054 |
すべての顧客・需要の予測結果を用いて,予測を行う関数 predict_using_automl_all
引数:
- demand_df: 顧客 (cust)・製品 (prod) ごとの日付 (date)と需要 (deman)の列を含んだデータフレーム
- promo_df: 追加特徴(プロモーション)情報を含んだデータフレーム(オプション);予測期間に対しても追加情報を準備する必要がある. 予測期間内のデータが空 (NaN)の場合には,訓練データにも空 (NaN)のものがある必要がある.
- summary: 予測結果をまとめたデータフレーム(automl_allの返値)
- customer: 顧客名
- product: 製品名
- agg_period: 期間を表す文字列(例えば1日のときは”1d”)
- forecast_periods: 予測したい期間(既定値は1)
返値: - forecast: 未来の予測値(リスト)
predict_using_automl_all
def predict_using_automl_all(
    demand_df, promo_df, summary, customer, product, agg_period:str='1d', forecast_periods:int=10
):
Call self as a function.
predict_using_automl_all関数の使用例
# customer = "長崎市"
# product = "D"
customer ="熊本市"
product ="H"
predict_using_automl_all(demand_df, promo_df, summary, customer, product, agg_period='1d', forecast_periods=10)| MAE | MSE | RMSE | R2 | RMSLE | MAPE | |
|---|---|---|---|---|---|---|
| 0 | 1.863 | 6.137 | 2.4773 | -9.6113 | 0.9757 | 1.4333 |
[2.0, 1.0, 4.0, 0.0, 0.0, 3.0, 4.0, 2.0, 2.0, 4.0]AutoMLによる予測関数 predict_using_automl
引数: - df: 日付 (date)と需要 (deman)の列を含んだデータフレーム - future: 訓練用と予測用の未来のデータを入れたデータフレーム - best: 予測モデルのオブジェクト - horizon: 予測期間
返値: - fig: 予測結果を入れた図オブジェクト - predict: 予測結果を入れた配列 - error: 予測の2乗誤差
predict_using_automl
def predict_using_automl(
    df, future, best, horizon:NoneType=None
):
AutoMLを用いた予測(回帰)
predict_using_automl関数の使用例
#fig, error, result = predict_using_automl(df, future, best[0])
#plotly.offline.plot(fig);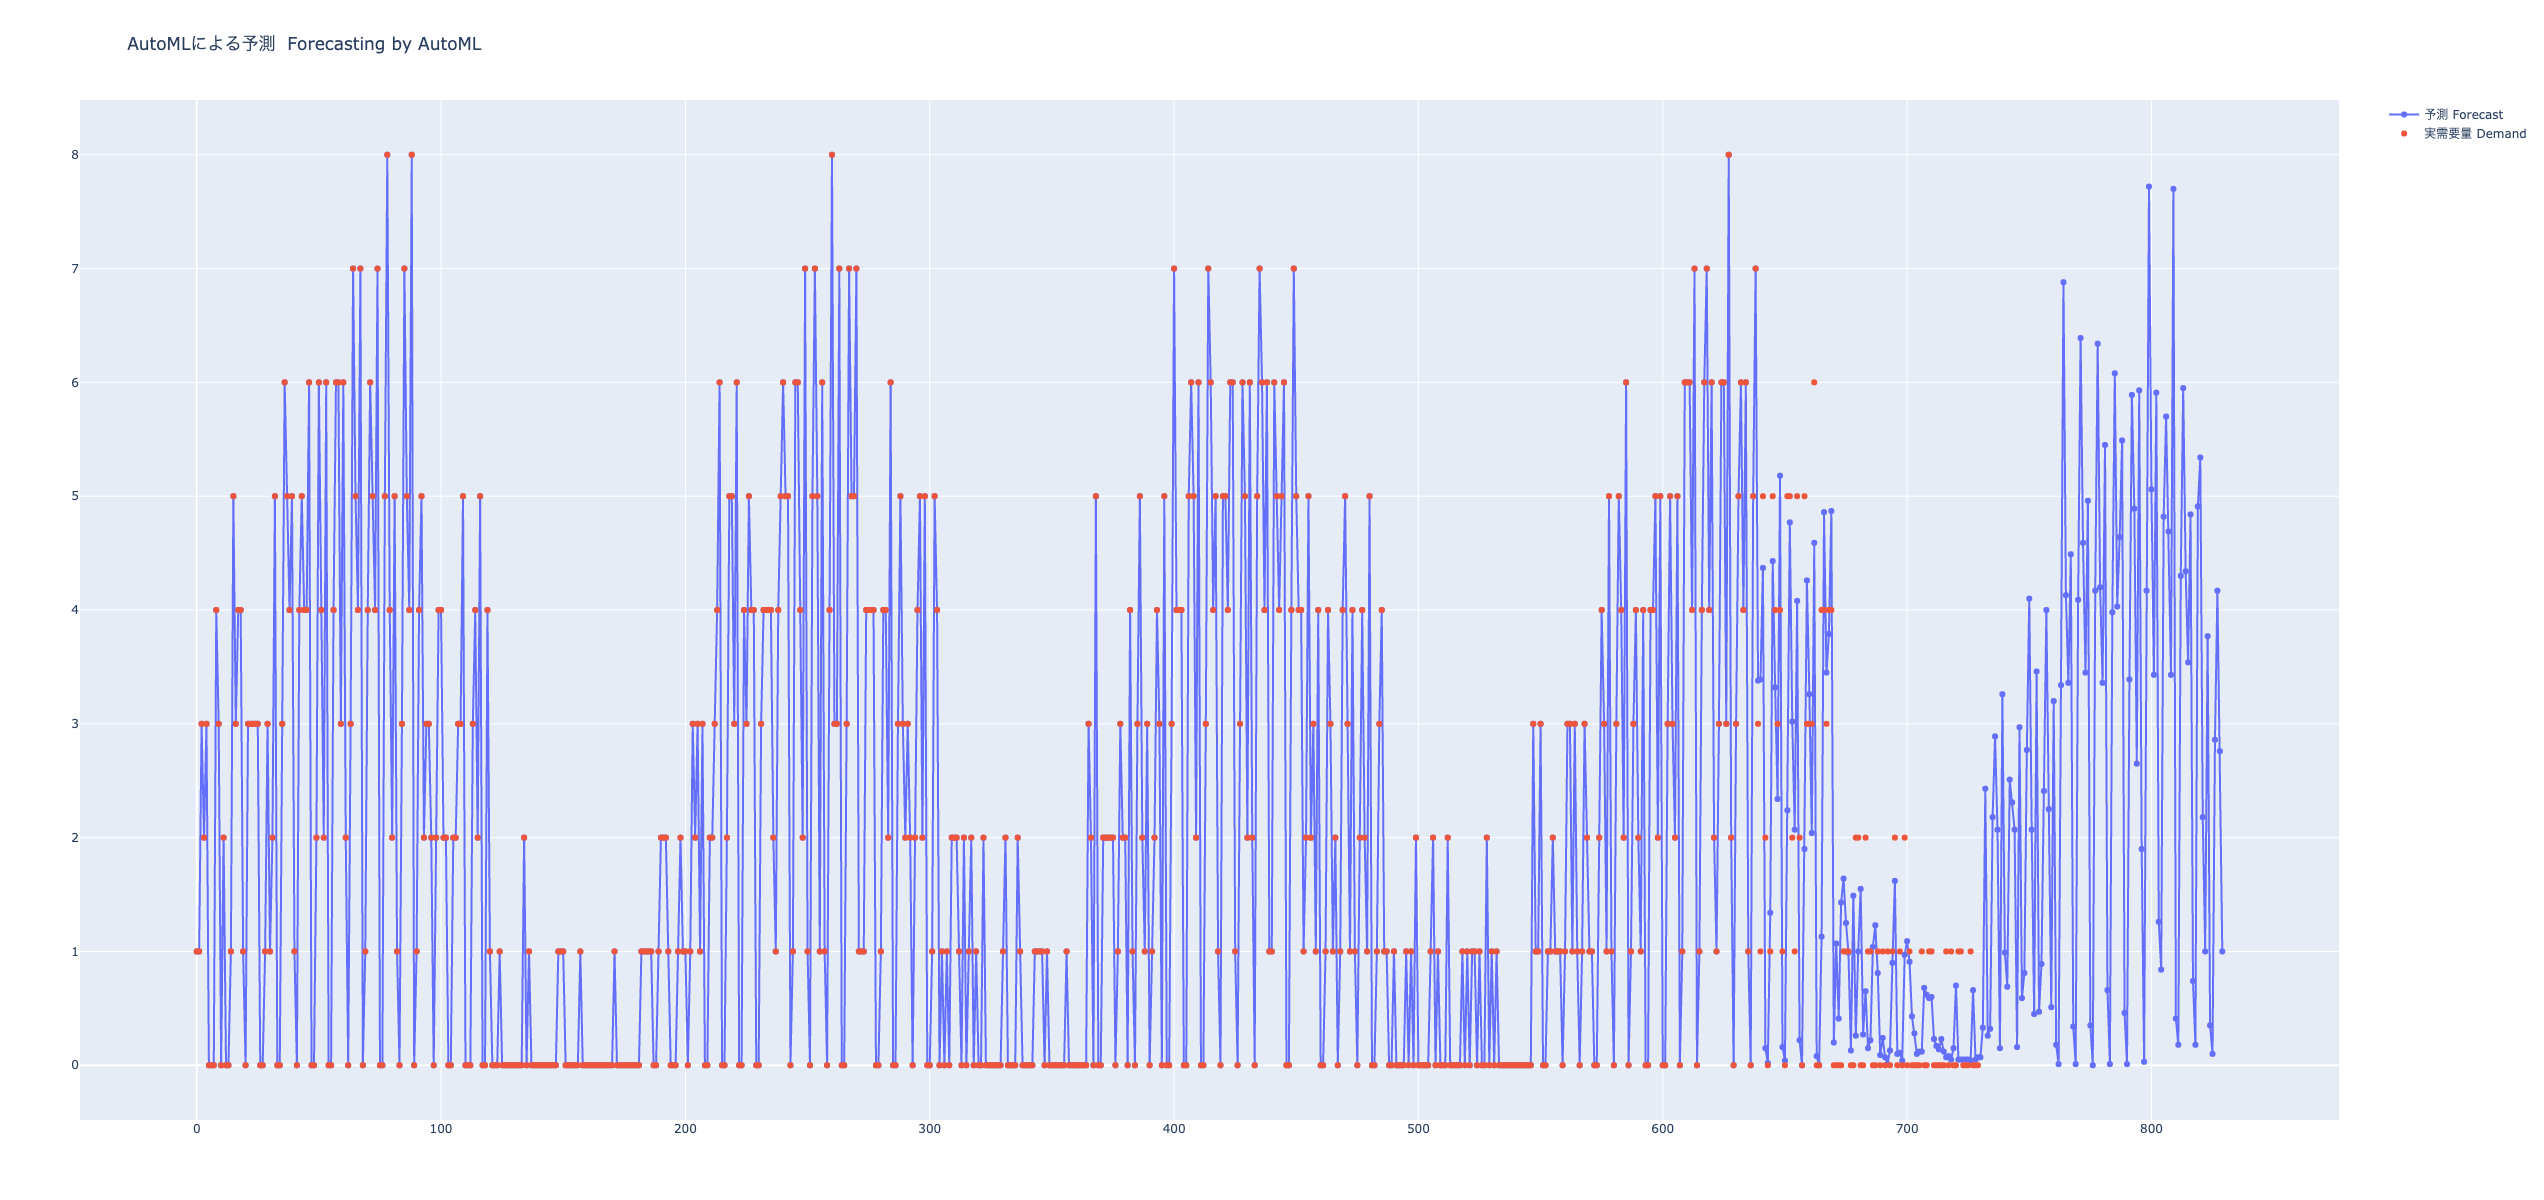
結果の可視化
- ‘residuals’ - Residuals Plot
- ‘error’ - Prediction Error Plot
- ‘cooks’ - Cooks Distance Plot
- ‘rfe’ - Recursive Feat. Selection
- ‘learning’ - Learning Curve
- ‘vc’ - Validation Curve
- ‘manifold’ - Manifold Learning
- ‘feature’ - Feature Importance
- ‘feature_all’ - Feature Importance (All)
- ‘parameter’ - Model Hyperparameter
- ‘tree’ - Decision Tree
plot_model(best[0], "feature_all", save=True)INFO:logs:Saving 'Feature Importance (All).png' in current active directory
INFO:logs:Visual Rendered Successfully
INFO:logs:plot_model() succesfully completed......................................'Feature Importance (All).png'分類モデル
from pycaret.classification import * #分類関連の関数のインポート#def automl(df, horizon=None, num_bests = 5, sort = "R2"):
"""
Prediction using pycaret classification models
"""
horizon = "2020/10/01"
num_bests = 1
sort = 'Accuracy'
train_idx, valid_idx = prepare_index(df, horizon)
ratio = len(train_idx)/(len(train_idx)+len(valid_idx))
df["Week"] = df.Week.astype(int)
df["demand"] = df.demand.astype('category')
#df["demand"] = df.demand.astype(int)
reg = setup(df, target = 'demand', session_id=123, data_split_shuffle=False, fold_strategy= 'timeseries', fold=2, train_size=ratio, silent=True, verbose=False)
best = compare_models(n_select=num_bests, sort = sort, cross_validation=False)
result_df = pull()
#return best, result_df| Model | Accuracy | AUC | Recall | Prec. | F1 | Kappa | MCC | TT (Sec) | |
|---|---|---|---|---|---|---|---|---|---|
| ridge | Ridge Classifier | 0.5165 | 0.0000 | 0.2857 | 0.2979 | 0.3735 | 0.2591 | 0.3110 | 0.0100 |
| rf | Random Forest Classifier | 0.5055 | 0.0000 | 0.2465 | 0.4723 | 0.4601 | 0.2719 | 0.2848 | 0.2100 |
| et | Extra Trees Classifier | 0.4725 | 0.0000 | 0.2212 | 0.4560 | 0.4504 | 0.2373 | 0.2428 | 0.1700 |
| lr | Logistic Regression | 0.4505 | 0.0000 | 0.1429 | 0.2030 | 0.2799 | 0.0000 | 0.0000 | 0.0200 |
| knn | K Neighbors Classifier | 0.4505 | 0.0000 | 0.1429 | 0.2030 | 0.2799 | 0.0000 | 0.0000 | 0.0000 |
| nb | Naive Bayes | 0.4505 | 0.0000 | 0.1429 | 0.2030 | 0.2799 | 0.0000 | 0.0000 | 0.0000 |
| qda | Quadratic Discriminant Analysis | 0.4505 | 0.0000 | 0.1429 | 0.2030 | 0.2799 | 0.0000 | 0.0000 | 0.0100 |
| lightgbm | Light Gradient Boosting Machine | 0.4396 | 0.0000 | 0.2687 | 0.4085 | 0.4170 | 0.2088 | 0.2120 | 1.1100 |
| lda | Linear Discriminant Analysis | 0.4066 | 0.0000 | 0.3163 | 0.4123 | 0.3898 | 0.1879 | 0.1927 | 0.0100 |
| xgboost | Extreme Gradient Boosting | 0.3956 | 0.0000 | 0.1998 | 0.4212 | 0.3911 | 0.1701 | 0.1751 | 1.3900 |
| ada | Ada Boost Classifier | 0.3407 | 0.0000 | 0.3163 | 0.3963 | 0.3462 | 0.1451 | 0.1545 | 0.0700 |
| gbc | Gradient Boosting Classifier | 0.3407 | 0.0000 | 0.2381 | 0.3764 | 0.3365 | 0.1332 | 0.1452 | 0.9300 |
| catboost | CatBoost Classifier | 0.3077 | 0.0000 | 0.1233 | 0.3130 | 0.3093 | 0.0510 | 0.0518 | 3.6100 |
| dt | Decision Tree Classifier | 0.2857 | 0.0000 | 0.2113 | 0.3375 | 0.2947 | 0.0424 | 0.0438 | 0.0100 |
| svm | SVM - Linear Kernel | 0.2527 | 0.0000 | 0.1429 | 0.0639 | 0.1020 | 0.0000 | 0.0000 | 0.0200 |
INFO:logs:create_model_container: 0
INFO:logs:master_model_container: 0
INFO:logs:display_container: 2
INFO:logs:RidgeClassifier(alpha=1.0, class_weight=None, copy_X=True, fit_intercept=True,
                max_iter=None, normalize=False, random_state=123, solver='auto',
                tol=0.001)
INFO:logs:compare_models() succesfully completed......................................
#検証データに対する予測
result = predict_model(best)
#誤差の計算
dem = result.demand.astype(int)
#error_ = ((result.Label - result.demand)**2).mean()
error_ = ((result.Label - dem)**2).mean()
#実需要量のプロット
trace2 = go.Scatter(
x = df.index,
y = df.demand,
mode = 'markers',
name ="実需要量 Demand"
)
#訓練+未来のデータに対する予測
result = predict_model(best, future)
#予測プロット
trace1 = go.Scatter(
x = result.index,
y = result.Label,
mode = 'markers + lines',
name = "予測 Forecast"
)
data = [trace1, trace2]
layout = go.Layout(
title ="AutoMLによる予測 Forecasting by AutoML",
)
fig = go.Figure(data, layout)
#return fig, error_, result
plotly.offline.plot(fig);INFO:logs:Initializing predict_model()
INFO:logs:predict_model(estimator=RidgeClassifier(alpha=1.0, class_weight=None, copy_X=True, fit_intercept=True,
max_iter=None, normalize=False, random_state=123, solver='auto',
tol=0.001), probability_threshold=None, encoded_labels=False, round=4, verbose=True, ml_usecase=MLUsecase.CLASSIFICATION, display=None)
INFO:logs:Checking exceptions
INFO:logs:Preloading libraries
INFO:logs:Preparing display monitor| Model | Accuracy | AUC | Recall | Prec. | F1 | Kappa | MCC | |
|---|---|---|---|---|---|---|---|---|
| 0 | Ridge Classifier | 0.5165 | 0 | 0.2857 | 0.2979 | 0.3735 | 0.2591 | 0.3110 |
INFO:logs:Initializing predict_model()
INFO:logs:predict_model(estimator=RidgeClassifier(alpha=1.0, class_weight=None, copy_X=True, fit_intercept=True,
                max_iter=None, normalize=False, random_state=123, solver='auto',
                tol=0.001), probability_threshold=None, encoded_labels=False, round=4, verbose=True, ml_usecase=MLUsecase.CLASSIFICATION, display=None)
INFO:logs:Checking exceptions
INFO:logs:Preloading libraries
INFO:logs:Preparing display monitor結果の可視化
plot_model(best, plot = 'feature', verbose=True)
#fig_param = plot_model(best, plot = 'parameter')
#interpret_model(best, plot = 'correlation')
#plot_model(best, plot = 'error')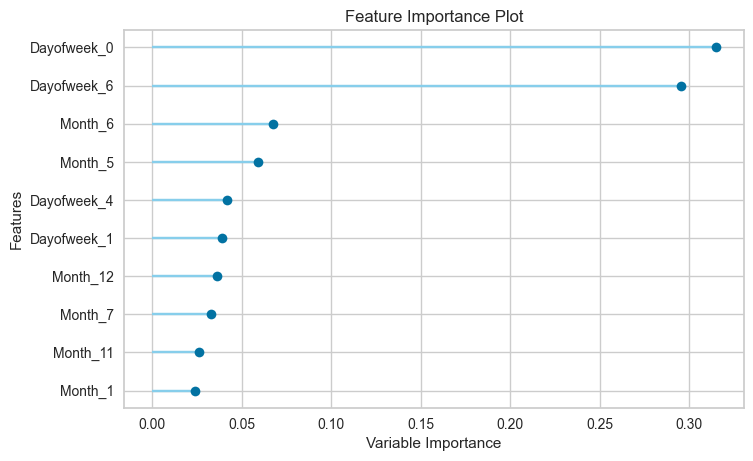
plot_model(best, plot = 'learning')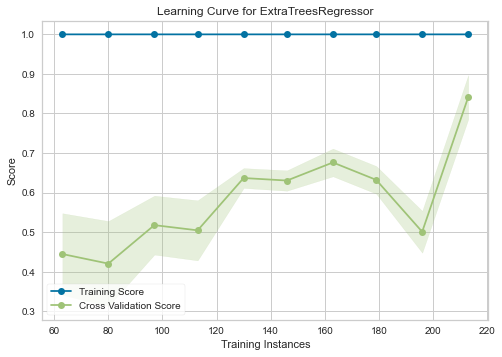
plot_model(best, plot = 'cooks')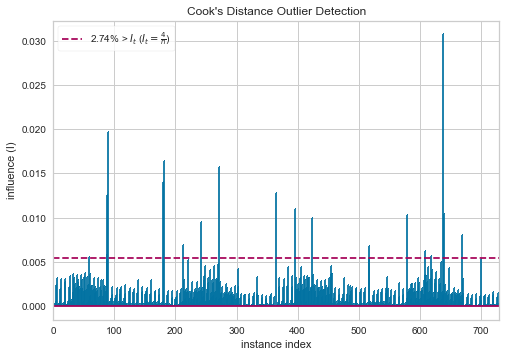
需要の集約
上では、顧客ごとに需要予測を行なった。ここでは、倉庫(配送センター、流通センター)ごとの予測や、工場ごとの予測について考える。
そのためには、ロジスティック・ネットワーク設計モデルで製品の流れを最適化した結果を用いる必要がある。
最適化した結果はflow.csvに保存されているので、そこから生成されたデータフレーム flow_df と需要データフレーム demand_df を入れると、 地点(工場、倉庫)ごとに集約された需要量を返す関数を準備する。
需要を地点ごとに集約する関数 aggregate_demand
引数: - demand_df : 需要データ - flow_df : 製品のフローを保管したデータ
返値: - aggregated_demand_df : 地点(工場、倉庫)と製品ごとに集約された需要データ - G: 製品をキーとし、フロー量を枝上に保管したグラフオブジェクト - Prod: 製品のリスト
aggregate_demand
def aggregate_demand(
    demand_df, flow_df
):
最適化された製品フローデータと需要データから、地点(工場、倉庫)ごとの集約された需要量を計算する関数
aggregate_demand関数の使用例
demand_df = pd.read_csv(folder+"demand.csv", index_col=0)
flow_df = pd.read_csv(folder+"flow.csv", index_col=0)
agg_demand_df, G, Prod = aggregate_demand(demand_df, flow_df)
agg_demand_df.head()| date | cust | prod | demand | |
|---|---|---|---|---|
| 0 | 2019-01-01 | DC_さいたま市 | A | 1.0 |
| 1 | 2019-01-01 | Plnt_Odawara | A | 5.0 |
| 2 | 2019-01-01 | DC_さいたま市 | B | 1.0 |
| 3 | 2019-01-01 | Plnt_Odawara | B | 4.0 |
| 4 | 2019-01-01 | DC_さいたま市 | C | 3.0 |
#グラフ G の描画
p ="B"
pos = G[p].layout()
nx.draw(G[p], pos=pos,  node_color="Blue", node_size=10)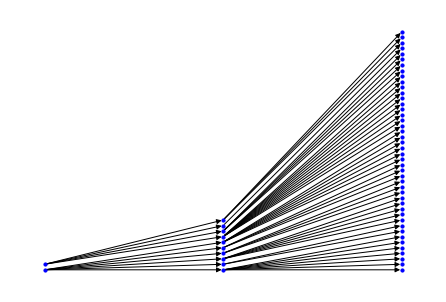
集約した需要をもとに安全在庫量を計算
単一ソース供給でない地点に対しては、安全在庫量を計算するための方法が確立されていない。 ここでは、異なるリード時間をもつ複数の地点から供給される場合には、ロジスティック・ネットワーク設計問題で求めた製品の年間フロー量をもとに、以下の方法で計算するものとする。
地点 \(j\) が、複数の地点 \(i (i \in S_j)\) からフロー量 \(f_{ij}\) で供給を受けているものとする。供給地点をフロー量の大きさに応じてランダムに選ぶものと仮定し、その確率を \(\lambda_{ij}\) とする。
\[ \lambda_{ij} = \frac{f_{ij}}{\sum_{i \in S_j} f_{ij}} \]
地点 \(i\) から地点 \(j\) へのリード時間を \(L'_{ij}\) としたとき、地点 \(j\) へのリード時間(確率変数) \(L_j\) は、確率 \(\lambda_{ij}\) で値 \(L'_{ij}\) をとる離散確率分布になる。
\(L_j\) の期待値 \(E[L_j]\) と分散 \(Var(L_j)\) は、scipyモジュールを使えば簡単に計算できる。 これらの値を使えば、平均 \(\mu\)、標準偏差 \(\sigma\) の正規分布にしたがう需要に対するリード時間内の需要量 \(D\) の期待値 \(E[D]\) と分散 \(Var(D)\) は、以下のように計算できる。
\[ E[D] = \mu E[L_j] \]
\[ Var(D) = \sigma E[L_j] + \mu^2 Var(L_j) \]
導出については、「はじめての確率論」(近代科学社)pp.92-94を参照されたい。
安全在庫量は、安全在庫係数を \(z\) としたとき、以下のように計算される。
\[ E[D] + z \sqrt{ Var(D) } \]
集約した需要をもとに安全在庫量を計算する関数 compute_safety_stock
引数: - demand_df : 需要データ - agg_demand_df : 地点(工場、倉庫)と製品ごとに集約された需要データ - trans_df : 地点間のリード時間を保管したデータ - plnt_prod_df : 工場ごとの製品の生産リード時間を保管したデータ - Prod: 製品のリスト - G: 製品をキーとし、フロー量を枝上に保管したグラフオブジェクト
返値: - safety_df : 地点・製品ごとの安全在庫量を保管したデータ
compute_safety_stock
def compute_safety_stock(
    demand_df, agg_demand_df, trans_df, plnt_prod_df, Prod, G
):
倉庫・工場・顧客に対する安全在庫量の計算
compute_safety_stock関数の使用例
#trans_df = pd.read_csv(folder + "trans.csv", index_col=0)
#plnt_prod_df = pd.read_csv(folder + "Plnt-Prod.csv", index_col=0)
safety_df = compute_safety_stock(demand_df, agg_demand_df, trans_df, plnt_prod_df, Prod, G)
#    safety_df.to_csv(folder+"safety.csv")