サプライ・チェイン基本分析システム SCBAS
基本分析モジュール abc とサプライ・チェイン基本分析システム SCBAS (Supply Chain Basic Analytics System)
はじめに
サプライ・チェイン・アナリティクスで最初に行うことは、需要データに対するABC分析である。 商品の需要量というのは、売れるものはたくさん売れるが、その数はごく少数であり、他のたくさんのそんなに売れない商品が山ほどあるという性質を持つ。 これをパレートの法則(全体の数値の大部分は、全体を構成するうちの一部の要素が生み出しているという理論。別名、80:20の法則、もう1つの別名、ばらつきの法則)と呼ぶ。
ここでは、仮想の企業の需要を生成し、それに対してABC分析を行う。 同時に、商品を売れている順に順位をつけ、順位の時系列的な変化を示すランク分析を提案する。
さらに、簡単な在庫分析を行う。これは、平均需要量や生産固定費用から、生産ロットサイズや安全在庫量を計算するものであり、 古典的な経済発注量モデルや安全在庫モデル(新聞売り子モデル)に基づくものである。
データの読み込み
まずは基本となるデータを読み込む。製品データはオプションであり、需要を売り上げや需要を重量や容量で評価したい場合に使う。 基本は、需要データ demand_df だけを使えば十分である。
需要データは以下の列をもつ.
- date: 日付
- cust: 顧客名
- prod: 製品名
- demand: 需要量
- sales: 売上
需要量demandと売上の何れかに対して,ABC分析を行う.
prod_df = pd.read_csv(folder+"Prod.csv",index_col=0)
prod_df.head()| name | weight | volume | cust_value | dc_value | plnt_value | fixed_cost | |
|---|---|---|---|---|---|---|---|
| 0 | A | 2 | 0 | 7 | 1 | 1 | 14 |
| 1 | B | 5 | 0 | 5 | 1 | 1 | 14 |
| 2 | C | 1 | 0 | 5 | 1 | 1 | 19 |
| 3 | D | 3 | 0 | 5 | 1 | 1 | 17 |
| 4 | E | 1 | 0 | 10 | 1 | 1 | 18 |
demand_df = pd.read_csv(folder+"demand.csv",index_col=0)
demand_df.head()| date | cust | prod | demand | sales | |
|---|---|---|---|---|---|
| index | |||||
| 0 | 2019-01-01 | 札幌市 | A | 10 | 10 |
| 1 | 2019-01-01 | 札幌市 | B | 10 | 10 |
| 2 | 2019-01-01 | 札幌市 | C | 3 | 3 |
| 3 | 2019-01-01 | 札幌市 | D | 0 | 0 |
| 4 | 2019-01-01 | 札幌市 | E | 37 | 37 |
Kaggleデータの読み込み
以下で配布されているデータを読み込む.
https://www.kaggle.com/kyanyoga/sample-sales-data
Kaggleデータを用いたい場合には,以下を実行する. ただし,製品データがないので,製品関連の関数は適用できない.
kaggle_df = pd.read_csv(folder + "sales_data_sample.csv",encoding="latin")
kaggle_df.head()| ORDERNUMBER | QUANTITYORDERED | PRICEEACH | ORDERLINENUMBER | SALES | ORDERDATE | STATUS | QTR_ID | MONTH_ID | YEAR_ID | ... | ADDRESSLINE1 | ADDRESSLINE2 | CITY | STATE | POSTALCODE | COUNTRY | TERRITORY | CONTACTLASTNAME | CONTACTFIRSTNAME | DEALSIZE | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 0 | 10107 | 30 | 95.70 | 2 | 2871.00 | 2/24/2003 0:00 | Shipped | 1 | 2 | 2003 | ... | 897 Long Airport Avenue | NaN | NYC | NY | 10022 | USA | NaN | Yu | Kwai | Small |
| 1 | 10121 | 34 | 81.35 | 5 | 2765.90 | 5/7/2003 0:00 | Shipped | 2 | 5 | 2003 | ... | 59 rue de l'Abbaye | NaN | Reims | NaN | 51100 | France | EMEA | Henriot | Paul | Small |
| 2 | 10134 | 41 | 94.74 | 2 | 3884.34 | 7/1/2003 0:00 | Shipped | 3 | 7 | 2003 | ... | 27 rue du Colonel Pierre Avia | NaN | Paris | NaN | 75508 | France | EMEA | Da Cunha | Daniel | Medium |
| 3 | 10145 | 45 | 83.26 | 6 | 3746.70 | 8/25/2003 0:00 | Shipped | 3 | 8 | 2003 | ... | 78934 Hillside Dr. | NaN | Pasadena | CA | 90003 | USA | NaN | Young | Julie | Medium |
| 4 | 10159 | 49 | 100.00 | 14 | 5205.27 | 10/10/2003 0:00 | Shipped | 4 | 10 | 2003 | ... | 7734 Strong St. | NaN | San Francisco | CA | NaN | USA | NaN | Brown | Julie | Medium |
5 rows × 25 columns
kaggle_df["date"] = pd.to_datetime(kaggle_df.ORDERDATE)
kaggle_df.rename(columns={"PRODUCTLINE":"prod", "CITY":"cust", "QUANTITYORDERED":"demand", "SALES":"sales"}, inplace=True)
demand_df = kaggle_df[["date","cust","prod","demand","sales"]].copy()
demand_df.head()| date | cust | prod | demand | sales | |
|---|---|---|---|---|---|
| 0 | 2003-02-24 | NYC | Motorcycles | 30 | 2871.00 |
| 1 | 2003-05-07 | Reims | Motorcycles | 34 | 2765.90 |
| 2 | 2003-07-01 | Paris | Motorcycles | 41 | 3884.34 |
| 3 | 2003-08-25 | Pasadena | Motorcycles | 45 | 3746.70 |
| 4 | 2003-10-10 | San Francisco | Motorcycles | 49 | 5205.27 |
需要と売り上げのtreemapを生成する関数 demand_tree_map
引数: - 需要データフレーム(需要 demand と売り上げ sales の列を含む)
返値: - Plotlyのtreemapオブジェクト
demand_tree_map
def demand_tree_map(
    demand_df
):
需要と売り上げのtreemapを生成する関数
demand_tree_mapの使用例
sales列がない場合には,dataモジュールのdemand_attribute_compute関数を用いてsales(売り上げ)列を計算することができる。
需要のtreemapは,需要の大きさを面積とした階層図であり,売上は色で表現している.
fig = demand_tree_map(demand_df);
plotly.offline.plot(fig);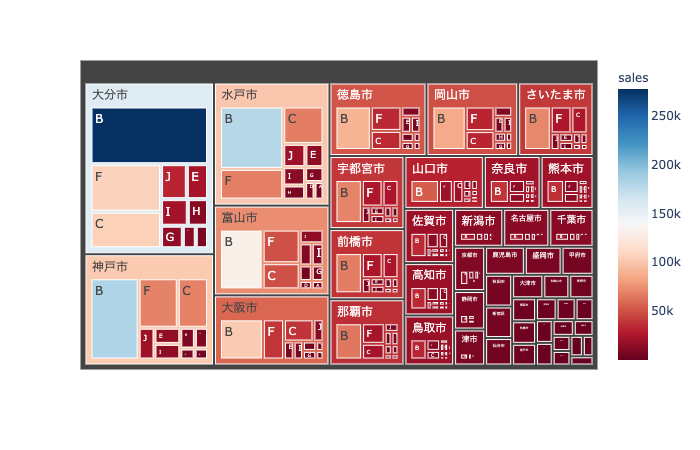
ABC分析とランク分析を行うための関数 abc_analysis
ABC分析のための関数を記述する、基本的には、需要データ demand_df だけあれば良いが、顧客や製品に関連した量を分析に加えたいときには、顧客データ cust_df や 製品データ prod_df も読み込んでおく。
古典的なABC分析では、3つのカテゴリーに製品や顧客を分類していたが、場合によっては4つに分類したい場合もあるだろう。 ここでは、より一般的にユーザーが与えた任意の数への分類を行う関数を準備する、カテゴリーに含まれる需要量を、ユーザーが与えた閾値をもとにして分類を行う。
引数:
- df: ABC分析を行うための需要データフレーム.列に集約を行うための列と値を格納した列が必要.
- threshold: A,B,C の分類を行うための閾値.上位 threshold[0]の要素がAランク,次に上位の threshold[1]がBランク、と順に決めていく。 リストの長さは(アルファベットの数以下の)任意の正数であるが、合計が1以上になるような数値のリストとして与える.
- agg_col: 集約を行う列名を文字列として与える.
- value_column: A,B,Cの分類を行うための数値データを保管した列名を文字列として与える.
- abc_name: 分類した結果を入れるための列名を文字列として与える.
- rank_name: 数値データの順位を入れた列名を文字列として与える.
返値: 以下の3つのオブジェクトのタプル:
- agg_df: agg_colによって集約したデータをvalue_columnの数値の大きい順に並べたデータフレーム.abcとrankの情報が付加されている.
- new_df: 元のデータフレームにabc_nameで与えた列にA(=0),B(=1),C(=2)の分類を,rank_nameで与えた列にランク(順位)を入れている.
- category: 0,1,2, …をキーとして与えると A,B,C,… ランクに属するデータ名(agg_colの要素)のリストを値として返す辞書.
abc_analysis
def abc_analysis(
    df, threshold, agg_col, value_column, abc_name, rank_name
):
ABC分析のための関数
顧客・製品の組に対するABC分析 abc_analysis_all
顧客・製品ごとに需要予測を行う際に,予測しなくても良い組を予め抜き出しておくことが重要になる.そのため,顧客・製品の組に対してABC分析とランク分析を行う関数を準備しておく.
引数:
- df: ABC分析を行うための需要データフレーム.列に集約を行うための列と値を格納した列が必要.
- threshold: A,B,C の分類を行うための閾値.上位 threshold[0]の要素がAランク,次に上位の threshold[1]がBランク、と順に決めていく。
返値: 以下の3つのオブジェクトのタプル:
- agg_df: 顧客・製品によって集約したデータをdemandの数値の合計(sum)の大きい順に並べたデータフレーム. abcとrankと需要の標準偏差 (std) の情報が付加されている.
- category: 0,1,2, …をキーとして与えると A,B,C,… ランクに属するデータ名(agg_colの要素)のリストを値として返す辞書.
abc_analysis_all
def abc_analysis_all(
    df, threshold
):
Call self as a function.
abc_analysis(_all)関数の使用例
以下では、製品と顧客に対してABC分析を行い、得られた3種類のデータフレーム(元のデータフレームに列を追加したもの:new_df、製品データフレームagg_df_prod、顧客データフレーム:agg_df_cust)を示す。
- 確認用の小規模例
- 製品を需要量を元に3つのクラスに、閾値[0.4, 0.5, 0.1]を用いて分類
- 顧客を需要量を元に4つのクラスに、閾値[0.4, 0.3, 0.3, 0.1]を用いて分類
- 顧客・製品を元に4つのクラスに、閾値[0.4, 0.3, 0.3, 0.1]を用いて分類
#hide - 製品を売り上げを元に4つのクラスに、閾値[0.6, 0.2, 0.1, 0.1]を用いて分類 (これを行うためには、data_generationモジュールのdemand_attribute_compute関数で、Salesの列を生成しておく必要がある。)
agg_df_prod, new_df, category_prod = abc_analysis(
    demand_df, [0.4, 0.5, 0.1], 'prod', 'demand', "prod_ABC", "prod_rank")
agg_df_cust, new_df, category_cust = abc_analysis(
    demand_df, [0.4, 0.3, 0.3, 0.1], 'cust', 'demand', "customer_ABC", "customer_rank")
new_df.head()| index | cust | prod | demand | sales | abc | rank | prod_ABC | prod_rank | customer_ABC | customer_rank | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| date | |||||||||||
| 2003-02-24 | 0 | NYC | Motorcycles | 30 | 2871.00 | B | 2 | B | 2 | A | 2 |
| 2003-05-07 | 1 | Reims | Motorcycles | 34 | 2765.90 | B | 2 | B | 2 | B | 17 |
| 2003-07-01 | 2 | Paris | Motorcycles | 41 | 3884.34 | B | 2 | B | 2 | A | 4 |
| 2003-08-25 | 3 | Pasadena | Motorcycles | 45 | 3746.70 | B | 2 | B | 2 | B | 32 |
| 2003-10-10 | 4 | San Francisco | Motorcycles | 49 | 5205.27 | B | 2 | B | 2 | A | 5 |
agg_df_prod.head()| demand | rank | abc | |
|---|---|---|---|
| prod | |||
| Classic Cars | 33992 | 0 | A |
| Vintage Cars | 21069 | 1 | A |
| Motorcycles | 11663 | 2 | B |
| Trucks and Buses | 10777 | 3 | B |
| Planes | 10727 | 4 | B |
agg_df_cust.head()| demand | rank | abc | |
|---|---|---|---|
| cust | |||
| Madrid | 10958 | 0 | A |
| San Rafael | 6366 | 1 | A |
| NYC | 5294 | 2 | A |
| Singapore | 2760 | 3 | A |
| Paris | 2521 | 4 | A |
agg_df,category = abc_analysis_all(demand_df, threshold=[0.4, 0.3, 0.3, 0.1])
agg_df.head()| sum | std | rank | abc | ||
|---|---|---|---|---|---|
| cust | prod | ||||
| Madrid | Classic Cars | 4139 | 9.376234 | 0 | A |
| San Rafael | Classic Cars | 2381 | 9.336030 | 1 | A |
| NYC | Classic Cars | 2306 | 9.134373 | 2 | A |
| Madrid | Vintage Cars | 2272 | 8.772440 | 3 | A |
| San Rafael | Vintage Cars | 1753 | 8.389640 | 4 | A |
元のデータフレームにabcとrankとdemandを追加する関数 add_abc
引数: - df: 製品や顧客のデータフレーム;これにABC分析の結果を追加する. - agg_df: 集約した需要,ABC分類,ランクを保管したデータフレーム;インデックスは製品(prod)もしくは顧客 (cust) - col_name: 追加したいデータの列名;製品の場合にはprod(既定値),顧客の場合にはcust
返値: - df: ランク,ABC分類,集約した需要量を追加したデータフレーム
add_abc
def add_abc(
    df, agg_df, col_name:str='prod'
):
Call self as a function.
add_abc関数の使用例
new_prod_df = add_abc(prod_df, agg_df_prod)
new_prod_df.head()| name | plnt_value | fixed_cost | demand | rank | abc | |
|---|---|---|---|---|---|---|
| 0 | A | 1 | 14 | 18026 | 3 | B |
| 1 | B | 1 | 14 | 17592 | 4 | B |
| 2 | C | 1 | 19 | 6682 | 7 | C |
| 3 | D | 1 | 17 | 813 | 9 | C |
| 4 | E | 1 | 18 | 77704 | 0 | A |
ABC別に色分けした需要のtreemapを生成する関数
引数: - 需要データフレーム(需要 demand,売り上げ sales,customer_ABC, prod_ABCの列を含む; ABC分析で得られたnew_df)
返値: - Plotlyのtreemapオブジェクト
demand_tree_map_with_abc
def demand_tree_map_with_abc(
    demand_df
):
ABC別に色分けした需要のtreemapを生成する関数
demand_tree_map_with_abc関数の使用例
fig = demand_tree_map_with_abc(new_df)
plotly.offline.plot(fig);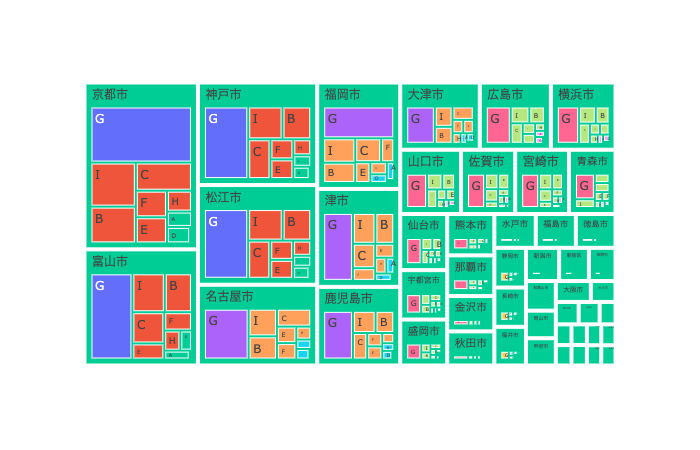
需要データフレームからABC分析の図とデータフレームを生成する関数 generate_figures_for_abc_analysis
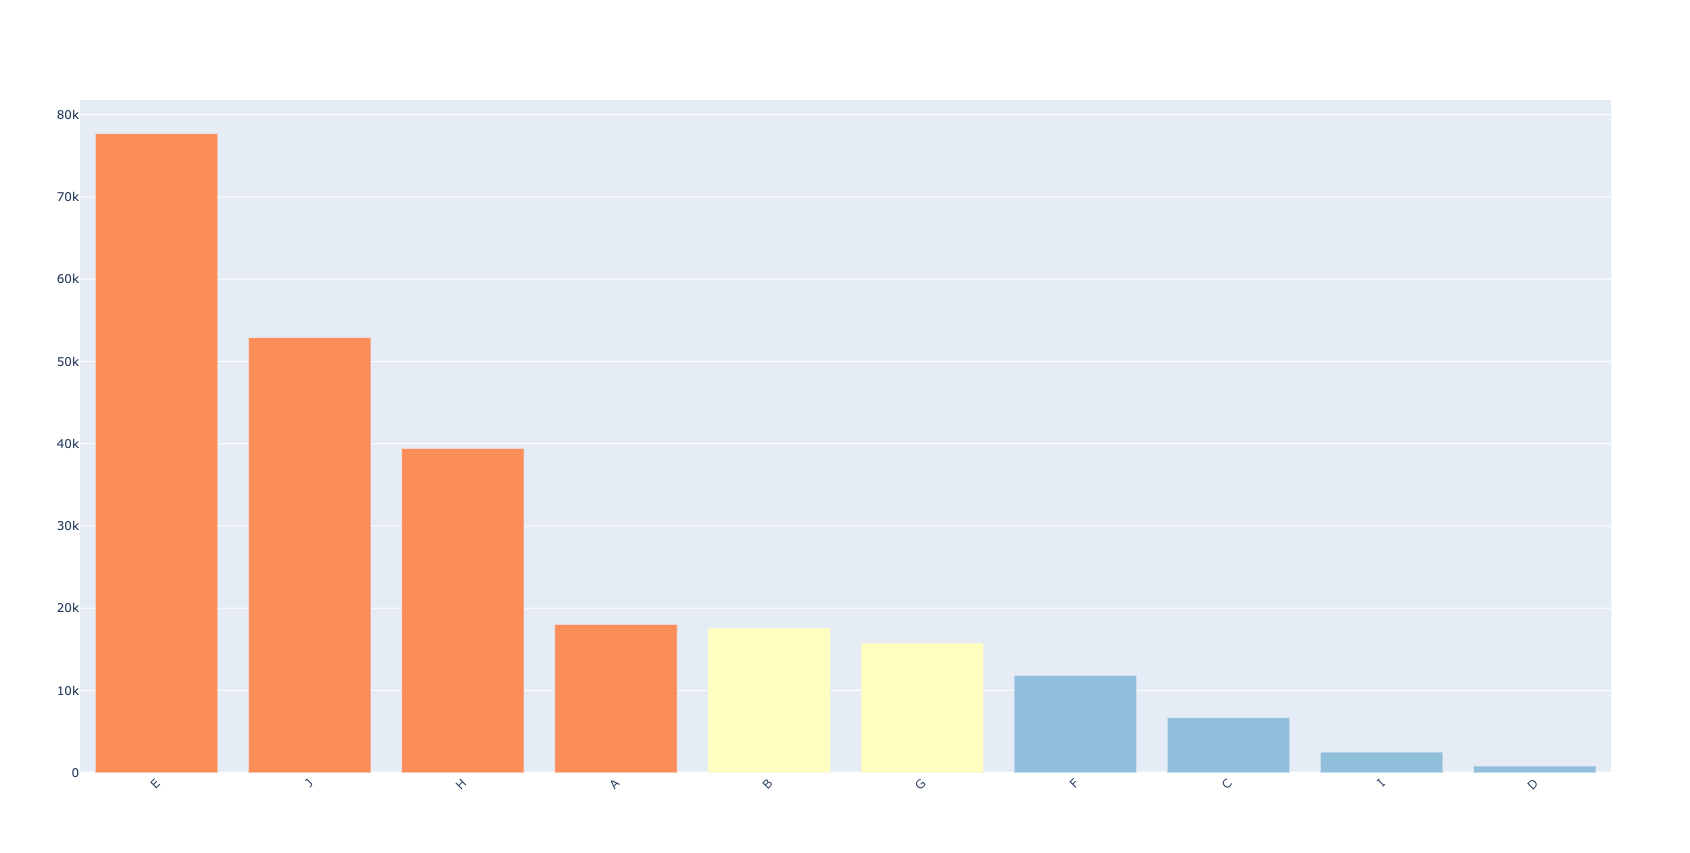
顧客と製品の両方に対するABC分析を同時に行い、結果の図とデータフレームを同時に得るには、この関数を用いる。
引数:
- demand_df : 需要データフレーム
- value_name: 分析をするデータが入っている列名(既定値は”demand”)
- cumsum : 図を累積値で描画するときには True
- cust_thres : 顧客のABC分析するときの閾値を文字列で表したもの
- prod_thres : 製品のABC分析するときの閾値を文字列で表したもの
返値:
- fig_prod : 製品のABC分析のPlotly図オブジェクト
- fig_cust : 顧客のABC分析のPlotly図オブジェクト
- agg_df_prod : 製品をインデックスとしたABC分析のデータフレーム
- agg_df_cust : 顧客をインデックスとしたABC分析のデータフレーム
- new_df : 顧客と製品のABCとランクを加えた新しい需要データフレーム
generate_figures_for_abc_analysis
def generate_figures_for_abc_analysis(
    demand_df, value_name:str='demand', cumsum:bool=True, cust_thres:str='0.7, 0.2, 0.1',
    prod_thres:str='0.7, 0.2, 0.1'
):
Call self as a function.
generate_figures_for_abc_analysis関数の使用例
fig_prod, fig_cust, agg_df_prod, agg_df_cust, new_df = generate_figures_for_abc_analysis(
demand_df, value_name="sales", cumsum = False, cust_thres="0.7, 0.2, 0.1", prod_thres="0.7, 0.2, 0.1")
plotly.offline.plot(fig_prod);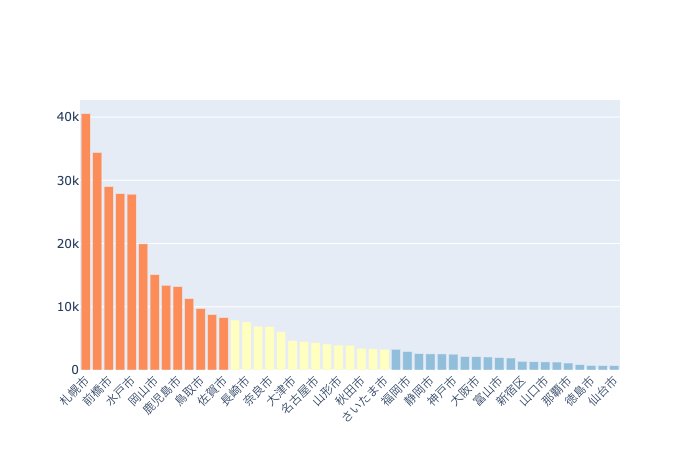
ランク分析のための関数 rank_analysis と rank_analysis_all_periods
全ての期に対するランク分析を行う関数 rank_analysis と、期ごと(集約する単位は文字列で与える)のランク分析を行う関数 rank_analysis_all_periodsを記述する。
引数:
- df: ランク分析を行う対象の需要データフレーム.列に集約を行うための列と,値を格納した列が必要.
- agg_col: 集約を行う列名を文字列として与える.
- value_column: ランクを計算するための数値データを保管した列名を文字列として与える.
- agg_period (rank_analysis_all_periodsの場合のみ) : 集約を行う期間を “1m”(月次)のような文字列で与える.
返値:
- 名前を入れるとランク(rank_analysisの場合)もしくランクの期別リスト(rank_analysis_all_periodsの場合)を返す辞書
rank_analysis
def rank_analysis(
    df, agg_col, value_column
):
全期間分のランク分析のための関数
rank_analysis_all_periods
def rank_analysis_all_periods(
    df, agg_col, value_col, agg_period
):
期別のランク分析のための関数
ランク分析の関数の使用例
全期間分の顧客需要のランク分析と、3ヶ月を1期とした各期間に対する製品のランク分析。
dic = rank_analysis(demand_df, 'cust', 'demand') #全ての期間に対する顧客需要量のランク分析
dic.popitem()
('Charleroi', 73)dic = rank_analysis_all_periods(demand_df, 'prod', 'demand', "1d")
#dic.popitem()ランク分析の可視化関数 show_rank_analysis
ランクの時系列的な変化を表す図を生成するための関数。
引数:
- df: ランク分析を行う対象の需要データフレーム.列に集約を行うための列と,値を格納した列が必要.
- value_name: 分析をするデータが入っている列名(既定値は”demand”)
- agg_period: 集約を行う期間を “1m”(月次)のような文字列で与える.
- top_rank: 上位 top_rank 個のものだけを表示する
返値:
- Plotlyの図オブジェクト
show_rank_analysis
def show_rank_analysis(
    demand_df, value_name:str='demand', agg_period:str='1m', top_rank:int=1
):
ランク分析の可視化関数
show_rank_analysis関数の使用例
fig = show_rank_analysis(demand_df, value_name="sales", agg_period ="1d", top_rank = 10)
plotly.offline.plot(fig);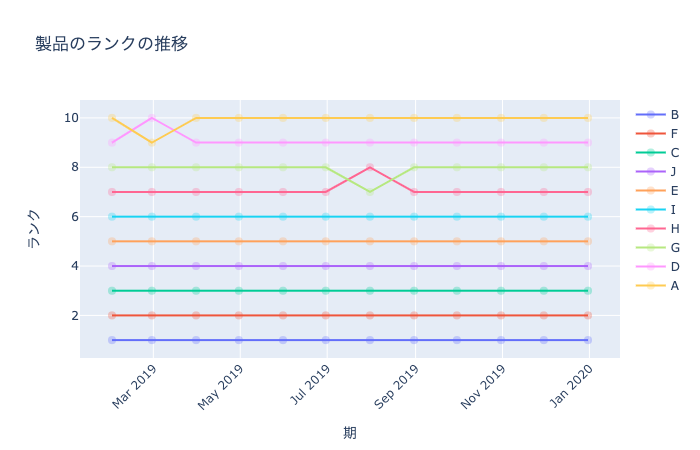
リスク共同管理分析 risk_pooling_analysis
在庫をサプライ・チェインの上流(供給側)でもつか、下流(需要側)でもつかは、複数の需要地点(顧客)における需要の相関で決まる。 一般には、上流で在庫を共有することによって在庫の削減ができる。これをリスク共同管理 (risk pooling) とよぶ。
ここでは、製品ごとに、顧客の需要の標準偏差とリスク共同管理した場合の標準偏差の差を計算する。 また、それを需要の総量で割った比率(削減率)も計算する。 これは、標準偏差を平均値で割ることによる無次元の指標(変動係数: coefficient of variation: CV)に相当するものである。
この値が大きい製品ほど、リスク共同管理の効果が大きいので、サプライ・チェインの上流で在庫を保持した方が良いことになり、 逆に小さい製品ほど、下流で在庫を保持した方が良いことになる。
引数: - demand_df: 需要のデータフレーム - agg_period: 標準偏差を計算する際に用いる需要の集約を行う期(規定値は週)
返値: - inv_reduction_df : 標準偏差とその差と削減率を製品ごとに計算したデータフレーム; Rank列は製品の順位
risk_pooling_analysis
def risk_pooling_analysis(
    demand_df, agg_period:str='1w'
):
リスク共同管理の効果を見るための関数
在庫を顧客側においた場合と、倉庫側においた場合の差を、標準偏差を計算することによって推定する。
risk_pooling_analysis関数の使用例
1週間を単位とした標準偏差をもとに、在庫を倉庫に置いた場合と工場に置いた場合の差を計算し、それを需要の総量で除した削減率(ReductionRatioの列)を計算する。 Plotlyによる可視化では、削減率の大きいものから棒グラフで表示し、需要の大きさのランクで色分けをする。
inv_reduction_df = risk_pooling_analysis(demand_df, agg_period="1w")
inv_reduction_df.head()| rank | prod | agg_std | sum_std | reduction | reduction_ratio | |
|---|---|---|---|---|---|---|
| 0 | 10 | D | 20.506097 | 61.518290 | 41.012193 | 0.050446 |
| 1 | 9 | I | 101.823376 | 142.835570 | 41.012193 | 0.016353 |
| 2 | 8 | C | 302.641702 | 332.340187 | 29.698485 | 0.004445 |
| 3 | 4 | A | 749.533188 | 782.060100 | 32.526912 | 0.001804 |
| 4 | 7 | F | 513.359523 | 524.673232 | 11.313708 | 0.000956 |
在庫削減量の可視化関数 show_inventory_reduction
show_inventory_reduction
def show_inventory_reduction(
    inv_reduction_df
):
在庫削減量の可視化関数
fig = show_inventory_reduction(inv_reduction_df)
plotly.offline.plot(fig);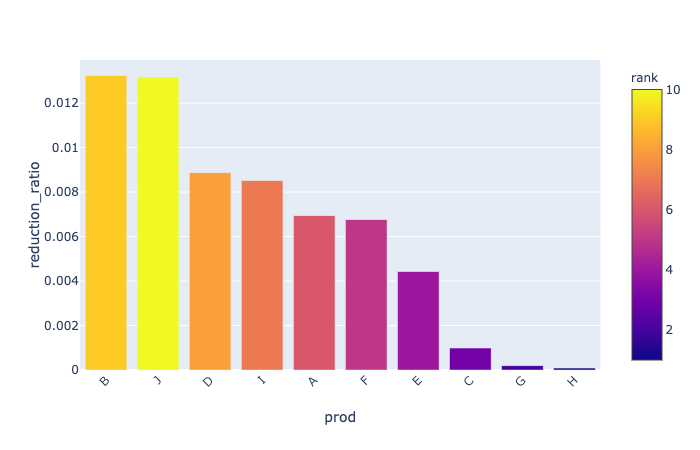
需要の製品ごとの平均と変動係数の可視化関数 show_mean_cv
需要を製品ごとに集約し,横軸に平均,縦軸に変動係数(\(CV=\sigma/\mu\))の対数をとった散布図を生成する.
平均が大きく,変動係数が小さい製品は安定しているので倉庫(サプライ・チェインの下流)で保管し,平均が小さく変動係数が大きい製品は,工場(サプライ・チェインの上流)で 保管し,適宜顧客側に流す戦略が望ましい.
引数: - demand: 需要データフレーム - show_name: Trueのとき製品名も描画する.
返値: - fig: Plotlyの図オブジェクト
show_mean_cv
def show_mean_cv(
    demand_df, show_name:bool=True
):
Call self as a function.
show_mean_cv関数の使用例
fig = show_mean_cv(demand_df, show_name=True)
#plotly.offline.plot(fig);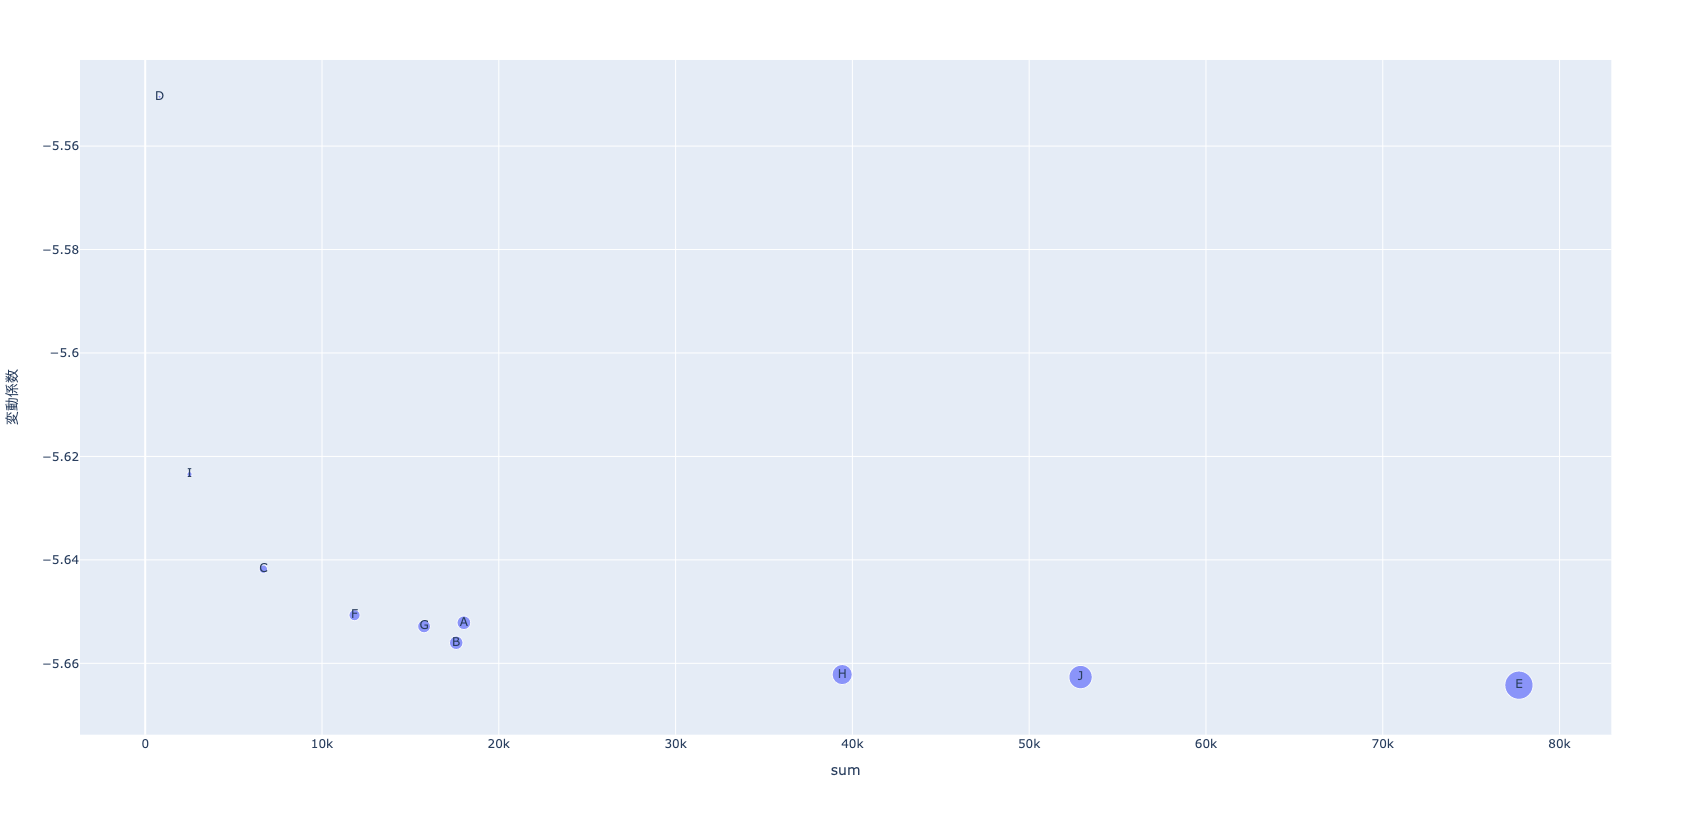
安全在庫、ロットサイズ、目標在庫(基在庫レベル)の設定関数 inventory_analysis
全ての需要が1つの工場で生産していると仮定したとき、その生産ロットサイズや安全在庫量は、古典的な経済発注量モデルと新聞売り子モデルで計算できる。
安全在庫量: 安全在庫係数 \(z\), リード時間 \(L\), 需要の標準偏差 \(\sigma\) としたとき \(z\sqrt{LT}\sigma\)
経済発注量(生産ロットサイズ): 生産固定費用 \(FC\)、需要の平均値 \(d\)、在庫費用 \(h\) としたとき \(\sqrt{2 FCd/h}\)
保管費率(無次元): \(r\) は以下の量の和とする。
- 利子率(投資額利率)
- 保険料率: 製品の種類および企業の方針によっても異なる.
- 消耗費率および陳腐化率: 製品の腐敗,破損,目減りなどを考慮して計算
- 税率: 在庫に課せられる法的な税率(日本では0)
在庫費用: \(h\) は、保管費率 \(r\) に製品の価値(製品データのplnt_value列)を乗じたものを週あたりに換算したもの
目標在庫量 \(=\) 安全在庫量 \(+\) ロットサイズ
初期在庫量 \(=\) 安全在庫量と目標在庫量の平均
引数:
- prod_df: 製品データフレーム
- demand_df: 多期間の製品別需要データフレーム
- inv_reduction_df : 標準偏差とその差と削減率を製品ごとに計算したデータフレーム
- z: 安全在庫係数
- LT: リード時間
- r: 年間保管費率
- num_days: 標準偏差を計算する際の日数(既定値は \(7\))
返値: 以下の列情報を加えた製品データフレーム prod_df
- average_demand: num_days間の平均需要
- standard_deviation: 需要の標準偏差
- inv_cost: 在庫費用 $h = r $ plnt_value を1週間に換算したもの
- safety_inventory: 安全在庫量
- target_inventory: 目標在庫量(基在庫レベル); \(d LT + z\sqrt{LT}\sigma\)
- initial_inventory: 初期在庫量
inventory_analysis
def inventory_analysis(
    prod_df, demand_df, inv_reduction_df, z:float=1.65, LT:int=1, r:float=0.3, num_days:int=7
):
工場における安全在庫量の計算
工場を1箇所に集約したと仮定する。複数工場の場合には、顧客と工場の紐付け情報が必要になる。
inventory_analysis関数の使用例
1週間を基本単位として、在庫量削減データフレームを計算し、それをもとに工場での在庫量を求める。
prod_df = pd.read_csv(folder+"Prod.csv",index_col=0)

inv_reduction_df = risk_pooling_analysis(demand_df, agg_period="1w")
prod_df2 = inventory_analysis(prod_df, demand_df, inv_reduction_df, z = 1.65, LT = 1, r = 0.3, num_days=7)
prod_df2.set_index("index", inplace=True)
prod_df2.to_csv(folder + "Prod_with_inventory.csv")
prod_df2.head()| name | weight | volume | cust_value | dc_value | plnt_value | fixed_cost | average_demand | standard_deviation | inv_cost | lot_size | safety_inventory | target_inventory | initial_inventory | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| index | ||||||||||||||
| 0 | A | 2 | 0 | 7 | 1 | 1 | 14 | 11471.090909 | 749.533188 | 0.005753 | 7471.678242 | 1236.729760 | 8708.408003 | 4972.0 |
| 1 | B | 5 | 0 | 5 | 1 | 1 | 14 | 11194.909091 | 760.846897 | 0.005753 | 7381.184926 | 1255.397379 | 8636.582305 | 4945.0 |
| 2 | C | 1 | 0 | 5 | 1 | 1 | 19 | 4252.181818 | 302.641702 | 0.005753 | 5299.495116 | 499.358809 | 5798.853925 | 3149.0 |
| 3 | D | 3 | 0 | 5 | 1 | 1 | 17 | 517.363636 | 20.506097 | 0.005753 | 1748.534451 | 33.835059 | 1782.369511 | 908.0 |
| 4 | E | 1 | 0 | 10 | 1 | 1 | 18 | 49448.000000 | 3426.639462 | 0.005753 | 17589.860716 | 5653.955112 | 23243.815827 | 14448.0 |
生産・在庫シミュレーション inventory_simulation
上で生成したデータを用いて、シミュレーションを行う。生産は、安全在庫量を下回ったときに行われ、目標在庫量になるように生産量を決める。
引数:
- prod_df: 製品データ
- demand_df: 需要データ
返値:
- キーを製品名、値を、需要 demand、在庫 inventory、生産量 production を列とした時系列データフレームとした辞書
inventory_simulation
def inventory_simulation(
    prod_df, demand_df
):
(Q,R)方策のシミュレーション
inventory_simulation関数の使用例
製品 A に対する需要、在庫、生産量を表すデータフレームを表示する。
production_df = inventory_simulation(prod_df, demand_df)
production_df[prod_df.name[0]].head()| demand | inventory | production | |
|---|---|---|---|
| 2019-01-01 | 1397 | 3575.000000 | 0.000000 |
| 2019-01-02 | 1684 | 1891.000000 | 0.000000 |
| 2019-01-03 | 1796 | 95.000000 | 8613.408003 |
| 2019-01-04 | 1249 | 7459.408003 | 0.000000 |
| 2019-01-05 | 2083 | 5376.408003 | 0.000000 |
生産、在庫、需要の可視化関数 show_prod_inv_demand
show_prod_inv_demand
def show_prod_inv_demand(
    prod_name, production_df, scale:str='1d'
):
生産、在庫、需要の可視化関数
show_prod_inv_demand関数の使用例
fig = show_prod_inv_demand(prod_df.name[3], production_df, scale="1d")
plotly.offline.plot(fig);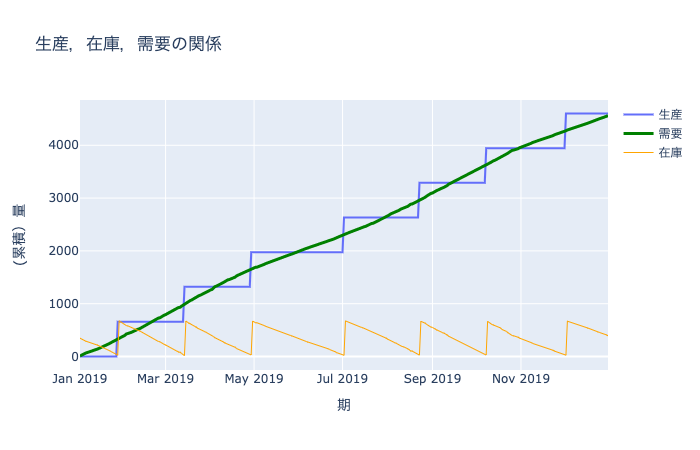
#hide ## 生産、需要、在庫の可視化
上で作成した production_df をDashで可視化するインターフェイスを作成する。
#hide ## Dashを用いたABC分析のダッシュボード
demand_dfを用いて、ABC分析、ランク分析、リスク共同管理分析を行う。